
Содержание
Источники проверены по состоянию на 28 сентября 2026 года.
Введение
AI-Disrupt PDLC объединяет представление об ИИ-нативной разработке программного обеспечения — разработке со встроенным в жизненный цикл ИИ — с архитектурой платформы, распределением ответственности, правилами автономии агентов, моделью зрелости и программой организационных изменений. Такой масштаб требует рассматривать документ сразу в нескольких плоскостях. Происхождение отдельного инструмента не определяет происхождение всей архитектуры, а наличие архитектурной связности не подтверждает автоматически ожидаемый экономический эффект.
Основной исследовательский вопрос этой работы:
Что представляет собой AI-Disrupt PDLC, если отделить происхождение его составляющих, характер авторского вклада и доказательный статус основных утверждений?
Для ответа на этот вопрос сначала необходимо реконструировать позицию авторов, затем исследовать предшественников и преобразования практик, после чего проверить количественные утверждения и границы их обобщения.
Моя работа не оценивает мотивы авторов и не устанавливает, следует ли организациям принимать или отвергать AI-Disrupt PDLC. Ее предмет — содержание опубликованной конструкции и основания, доступные внешнему профессиональному читателю.
1. Метод исследования
1.1. Корпус и датировка
Основной корпус состоит из двух документов:
- Полная версия: «AI-Disrupt PDLC. ИИ-нативная трансформация разработки ПО для зрелого корпоративного контура. Практическое руководство», версия 2.0, июнь 2026 года, 175 физических страниц PDF.
- Краткая версия: «AI-Disrupt PDLC. Инженерия намерения. Новая архитектура генеративной разработки ПО», Кирилл Меньшов, июнь 2026 года, 44 страницы PDF.
Полная версия доступна на официальном сайте проекта как PDF-руководство. В дальнейшем «полная версия, с. N» означает напечатанный номер страницы: ему соответствует физическая страница PDF N + 4. Для краткой версии используется физическая нумерация PDF. Мной исследуется содержание приложенных редакций; обновление файлов по публичным адресам впоследствии может изменить соответствие ссылок и страниц.
Дату первой публичной презентации и дату изучаемой редакции необходимо различать. Сообщение о выпуске руководства опубликовано в мае 2026 года; доступное сообщение CNews от 20 мая, передающее материал Сбера, используется только для установления публичного контекста. Оно не является независимой проверкой результативности подхода. Для генеалогии приоритет имеют источники, опубликованные до мая 2026 года. Материалы более поздней даты мной не рассматриваются как доказанные предшественники первоначального AI-Disrupt, даже если они предшествуют дате настоящего исследования.
1.2. Классификация элементов
| Категория | Операциональное значение | Что само по себе не следует из классификации |
|---|---|---|
| A. Предшествующая практика | Содержательно сопоставимый элемент документирован независимо до AI-Disrupt | Не доказывает прямого заимствования и не исключает новой композиции |
| B. Адаптация | Существующая практика существенно изменена применительно к агентной разработке (agentic development, с исполнением многошаговых задач агентами) или ИИ-нативной разработке | Не означает, что адаптация уже эмпирически проверена |
| C. Композиционный вклад | Известным элементам приданы определенные связи и роли в целой системе | Не означает абсолютного приоритета всей комбинации |
| D. Собственный конструкт | Достаточно близкий предшественник конкретной конструкции в проведенном поиске не обнаружен | Не доказывает абсолютной оригинальности |
| E. Авторская гипотеза | Нормативное, причинное или прогностическое положение, требующее самостоятельного обоснования | Не означает ложности положения |
| F. Эмпирическое утверждение | Положение предполагает проверку наблюдаемыми данными | Не означает, что такая проверка опубликована или достаточна |
Эти категории не взаимоисключающие. Например, известная практика может получить новую архитектурную роль — A и C; авторская схема может содержать неподтвержденную норму — D и E. Классификация относится к указанному аспекту элемента, а не автоматически ко всему разделу руководства.
1.3. Процедура анализа
Для каждого существенного элемента сопоставляются его определение в основном корпусе, датированные предшественники, изменения функции и место в архитектуре. Лексическое совпадение проверяется отдельно от функционального сходства. Совпадение слов не доказывает тождества конструкций; отсутствие одинакового названия не исключает содержательного предшественника. Прямую зависимость можно утверждать увереннее там, где авторы сами называют источник, как в случае с AWS AI-DLC.
Для доказательной базы мной используется цепочка:
Источник → наблюдение → интерпретация → обобщение → нормативный вывод.
На каждом переходе проверяется, сохраняются ли единица анализа, популяция, условия, горизонт и определение результата. Ускорение отдельного задания, рост числа артефактов, изменение времени поставки и бизнес-эффект рассматриваются как разные результаты. Прогноз аналитической организации подтверждает наличие соответствующей внешней оценки, но не подтверждает наступление прогнозируемого состояния.
Приоритет отдан публикациям авторов подходов, официальной документации и первичным исследованиям. Поиск не является исчерпывающим систематическим обзором всех корпоративных и академических архивов. Для конструкций D мной фиксируется результат ограниченного поиска, а не исторический приоритет.
1.4. Границы метода
- Отсутствие доступного первичного источника не доказывает отсутствия внутренних данных.
- Внутренние наблюдения Сбера могут быть достаточными для определенных внутренних решений, но их внешняя воспроизводимость зависит от опубликованной методики.
- Исследование анализирует опубликованный AI-Disrupt, а не фактическую внутреннюю разработку Сбера, и не включает собственный контролируемый эксперимент по внедрению подхода.
- Быстрое развитие агентной разработки дополнительно ограничивает перенос выводов между версиями инструментов и датами публикаций.
2. Объект исследования: реконструкция в собственной терминологии
2.1. Две петли и сквозные механизмы
Центральная конструкция полной версии — разделение процесса на Intent Loop и Implementation Loop. В первой люди при поддержке ИИ определяют задачу, ценность, ограничения и критерии результата. Во второй агенты с учетом заданных полномочий создают и изменяют реализацию. Петли различаются и по темпу: работа с намерением занимает дни и недели, отдельные циклы реализации — минуты, часы и дни. Это разделение доминирующих функций и ритмов, а не запрет людям участвовать в реализации или ИИ — в формировании намерения. Полная версия, § 2.1, с. 24–26.
Discovery — поиск и уточнение продуктовой задачи — включен в Intent Loop и предшествует выбору конкретного способа автоматизации. Предлагаемая последовательность охватывает возможность, PR/FAQ (описание будущей пользовательской ценности и ответы на ключевые вопросы), Outcome Hypothesis (проверяемую гипотезу результата), выбор между адаптацией процесса и его перепроектированием, проверку пригодности агентного подхода, выбор паттернов и карту человеческих решений. Mob Elaboration служит совместному уточнению задачи продуктовой и инженерной группой с участием ИИ.
Validation Spine обозначает сквозную проверку результата. Авторы прямо возражают против третьей, изолированной петли валидации, которая стала бы очередью между реализацией и выпуском. Проверки должны быть встроены в работу, а человеческое участие сохраняется для архитектурных и спорных решений. Governance Mesh задает контроль полномочий, политик, доказательств и соответствия требованиям. В подробном описании валидация входит в Governance Mesh как одно из его измерений; соотношение этих двух представлений рассмотрено ниже.
2.2. Спецификации, платформа и среда агента
SDD — Specification-Driven Development — рассматривает спецификации как авторитетный источник по отношению к производной реализации. Однако основная часть руководства конкретизирует этот тезис для существующих корпоративных систем: речь не идет об обязательной перегенерации всей кодовой базы. Спецификация должна описывать требуемое состояние, контракты и ограничения, а изменение проходит через постановку, генерацию, проверку и обновление спецификации. Отдельно предусматривается Outcome Check — последующая проверка гипотезы результата. Полная версия, § 2.3, с. 31–35.
IDP у авторов означает Integrated Development Platform. Это важно: в литературе по platform engineering — созданию и развитию общих платформенных возможностей для разработчиков — та же аббревиатура обычно используется для Internal Developer Platform, внутренней платформы разработки. В AI-Disrupt платформа должна объединить жизненный цикл, контекст, агентное исполнение, спецификации, проверки, управление моделями, аудит и экономику. Эти два значения одной аббревиатуры необходимо различать.
Harness — рабочее окружение агента: инструменты, контекст, инструкции, память, ограничения и телеметрия. Его роль шире простого интерфейса к модели: он определяет, какие действия возможны, какая обратная связь доступна и как сохраняется состояние работы. Golden Paths — поддерживаемые пути выполнения типовых инженерных задач — и библиотека повторно используемых паттернов должны уменьшать стоимость такой работы внутри этой среды.
ADLC — Agent Development Lifecycle относится к жизненному циклу агентов как продуктов. Он включает в себя спецификацию поведения, оценку, развертывание, мониторинг и реакцию на деградацию. Авторы различают разработку традиционного ПО с помощью агентов и разработку самого агентного продукта, хотя обе опираются на общую платформу. Полная версия, § 4.4, с. 96–98.
2.3. Полномочия, доказательства и организация
R0–R5 — классы разрешенной автономии агента с учетом риска, полномочий и условий исполнения. В подробной таблице уровней R0–R5 авторы относят к ним чтение, предложения, работу в ветке, автоматическое слияние при выполнении условий, многосессионную работу и автономный эксперимент в песочнице. Допустимый уровень должен зависеть от критичности, риска и сложности конкретной операции. Поэтому R5 в песочнице нельзя интерпретировать как неограниченное право изменять production.
L0–L5 — модель зрелости команды или организации: от отсутствия системной практики до координированных агентных команд. Она включает в себя процессы, инфраструктуру, валидацию и длительность автономной работы. Это другая ось по отношению к R0–R5: организационная зрелость не тождественна разрешению агенту на конкретное действие.
Guardian Agents наблюдают, проверяют, перенаправляют, блокируют или исправляют действия в зависимости от режима и полномочий. Они сами включены в систему управления: в полной версии AI-Disrupt PDLC предусмотрены их оценка, аудит и ограничения автономии. Следовательно, описание не вводит над системой контроля безусловно доверенного «суперагента».
Evidence Bundle — комплект свидетельств завершения работы. В § 2.11 перечислены восемь составляющих: изменение кода или PR (pull request, запрос на слияние изменений); результаты четырех классов evals (оценочных проверок поведения и результатов агента); стоимость; журнал сессии; подтверждения проверок и политик; объяснение действий для соответствующих уровней автономии; вклад в объем результата; связь с будущей проверкой Outcome Hypothesis. Последний пункт задает последующее обязательство проверки, а не доказывает бизнес-эффект в момент завершения разработки. Полная версия, с. 48.
Tiny Teams — небольшие продуктовые команды, опирающиеся на общую платформу и агентные мощности. Zero Friction — целевое устранение организационных разрывов и ожидания между стадиями при встроенных проверках. Outcome Hypothesis связывает изменение с метрикой, исходным и целевым значением, ранним индикатором, окном проверки и альтернативным действием при неподтверждении гипотезы.
Эта реконструкция показывает, что AI-Disrupt PDLC не сводится к технике генерации кода. Он охватывает продуктовую постановку, технологическую инфраструктуру, контроль исполнения, организационную структуру и измерение результата.
2.4. Полная и краткая версии как разные уровни изложения
Краткий whitepaper воспроизводит основную структуру AI-Disrupt: две петли, Discovery, IDP, SDD, управление и трансформацию ролей. При этом различия между версиями не сводятся к степени детализации. В заключении краткой версии, с. 43, необходимость трансформации сформулирована категорически, а будущая доступность технических решений связывается с почти нулевой стоимостью внедрения. В полной версии одновременно подробно обсуждаются капитальные и эксплуатационные расходы платформы, а стратегические прогнозы названы сценариями.
При сопоставлении версий важно различать область действия отдельных утверждений. Удешевление доступа к техническому решению не тождественно удешевлению его интеграции, контроля и организационного освоения. Если краткую формулировку понимать буквально как прогноз полной стоимости внедрения, опубликованная экономическая модель не устанавливает ее стремление к нулю. Если речь лишь о доступности знаний и готовых компонентов, область утверждения существенно уже.
Аналогично категорическая необходимость трансформации — нормативное и прогностическое положение E. Она не следует непосредственно из описания архитектуры и не проверяется одним показателем ускорения кодирования. При реконструкции конкретных механизмов это исследование опирается прежде всего на подробные определения полной версии, а более сильные итоговые формулировки краткого whitepaper рассматривает отдельно, не приписывая им недостающую методику.
3. Заявленный авторами и профессиональный статус
3.1. Какие определения используют авторы
В полной версии сосуществуют несколько определений. Титульное название обозначает документ как практическое руководство. В оглавлении и основном тексте используются «методология», «концепция» и «архитектура». Формулировка «живая архитектурная позиция» поясняется как единая система взглядов, а не хронология версий. Глоссарий определяет AI-Disrupt прежде всего как концепцию. Полная версия, с. 1–5.
Официальный сайт также использует несколько вариантов описания — подход, концепцию и стратегическое представление о разработке; автор назван автором методологии. Краткий whitepaper выносит на титульный лист «новую архитектуру». Публичное сообщение о выпуске руководства использует также термин framework. Такое разнообразие само по себе не является противоречием: профессиональный продукт может иметь несколько функций. Но используемые определения сами по себе еще не устанавливают профессиональный статус AI-Disrupt: его необходимо определять по содержательным признакам.
3.2. Критерии профессиональной классификации
Для профессиональной классификации AI-Disrupt в этом исследовании используются следующие рабочие определения. Они задают критерии дальнейшего анализа, но не претендуют на универсальность.
| Класс | Рабочий критерий |
|---|---|
| Метод | Воспроизводимая процедура решения определенной задачи: входы, действия, выходы и условия завершения |
| Методология | Согласованная система принципов и методов, объясняющая их выбор, взаимосвязь, область применения и ограничения |
| Framework | Структура понятий, ролей и практик, которую организация заполняет собственными решениями |
| Reference architecture | Образец компонентов, обязанностей и взаимодействий, допускающий разные конкретные реализации |
| Operating model | Распределение работы, ответственности, полномочий, ресурсов и механизмов управления |
| Maturity model | Уровни и критерии состояния или развития определенной способности |
| Набор практик | Совокупность приемов, применимых отдельно, без обязательной единой архитектуры |
| Conceptual model | Система понятий и отношений, используемая для объяснения предметной области |
Эмпирическая проверка эффективности — отдельная ось. Наличие слова «методология» не гарантирует экспериментального подтверждения; отсутствие контролируемого исследования не запрещает называть согласованную систему методов методологией в профессиональном смысле.
Здесь необходимо различать три вопроса: может ли продукт классифицироваться как методология, насколько новыми являются его составляющие и композиция, а также насколько эмпирически подтверждена эффективность системы как целого. Положительный ответ на первый вопрос не определяет ответы на второй и третий. Кроме того, содержательные свойства профессионального продукта следует отличать от формы публикации — практического руководства — и прикладного разреза, в котором часть взаимосвязанных практик может применяться модульно.
AI-Disrupt содержит процедуры Discovery, подготовки спецификации, проверки и управления агентами; это методические элементы. Но значительная часть документа задает целевое устройство и ориентиры, оставляя организации конкретизацию правил, порогов, интерфейсов и измерений. Поэтому последующий анализ должен проверять одновременно методологические свойства, архитектуру и operating model, не сводя статус к одному названию.
4. Происхождение основных конструкций
4.1. Discovery и PR/FAQ
В AI-Disrupt Discovery обязателен внутри Intent Loop: решение о том, что и зачем создавать, должно предшествовать агентному исполнению. PR/FAQ помогает сформулировать ценность с позиции будущего пользователя; последующие шаги проверяют, требуется ли изменение процесса и подходит ли для него агент.
Предшествующую этому практику можно установить с высокой точностью. Amazon описывает Working Backwards и PR/FAQ на примере AWS CDK в публикации 2021 года. Продуктовый поиск, связывающий желаемый результат, возможности и варианты решений, представлен, например, в описании Opportunity Solution Tree Терезы Торрес 2016 года. Эти источники подтверждают более раннее существование основных функций, но не устанавливают происхождение каждого шага схемы Сбера.
Преобразование этих практик в AI-Disrupt состоит в обязательном включении Discovery в архитектуру агентной разработки и добавлении agent-fit (оценки пригодности агентного подхода), выбора паттернов и карты человеческих решений.
Классификация:
A — предшествующие практики Discovery, PR/FAQ и продуктового поиска;
B — их адаптация к агентной разработке через agent-fit, выбор паттернов и карту человеческих решений;
C — их объединение в последовательность внутри Intent Loop;
E — обязательность этой последовательности для соответствующего класса задач.
Приоритет самого Discovery или PR/FAQ авторам AI-Disrupt приписывать нельзя; приоритет их конкретной связки требует более узкого сравнения.
4.2. Outcome Hypothesis
В полной версии Outcome Hypothesis имеет операциональный шаблон: метрика с baseline (исходным значением) и target (целевым значением), ранний индикатор (leading indicator), окно проверки — в частности 7, 14, 28 или 90 дней — и fallback (альтернативное действие при неподтверждении гипотезы). Такой шаблон позволяет связать поставку с предполагаемым изменением результата, но сам по себе не означает, что каждый выпуск создаст ожидаемую ценность.
Предшествующие практики установлены для функции измеримой продуктовой гипотезы и последующей проверки результата: это гипотезо-ориентированная продуктовая работа и контролируемые эксперименты. Исследование Microsoft об онлайн-экспериментах 2009 года документирует проверку продуктовых изменений через измеряемое поведение пользователей. В самом AI-Disrupt также обозначено влияние материалов McKinsey о перестраивании процессов вокруг агентов, но это не основание считать McKinsey первоисточником всей идеи продуктовой гипотезы.
Эти предшественники не устанавливают происхождение точного шаблона Outcome Hypothesis AI-Disrupt. В частности, Microsoft experimentation не рассматривается как источник именно сочетания baseline/target, leading indicator, временного окна и fallback.
Подтверждаемый вклад Сбера — конкретный шаблон и его роль в замыкании Intent, Evidence Bundle и последующего Outcome Check.
Классификация:
A — предшествующая функция измеримой продуктовой гипотезы и последующей проверки результата;
B — ее адаптация в конкретном шаблоне Outcome Hypothesis;
C — связь этого шаблона с Intent, Evidence Bundle и Outcome Check;
E — обязательность полей и выбор временных окон.
Формализация гипотезы позволяет проверить, достигнут ли заявленный результат, но сама по себе не доказывает, что наблюдаемое изменение вызвано именно поставкой. Для установления такой связи требуется соответствующий дизайн измерения.
4.3. AWS AI-DLC
AWS представила AI-Driven Development Life Cycle 31 июля 2025 года, хронологически до AI-Disrupt. В нем ИИ занимает центральную роль, работа начинается с business intent, а люди сохраняют критические решения. Процесс включает в себя Inception с Mob Elaboration, Construction и Operations; контекст и артефакты сохраняются для последующей работы. Это достаточно близкий архитектурный предшественник, который сама полная версия Сбера прямо называет и обсуждает.
AI-Disrupt меняет способ группировки процесса: две петли дополняются сквозной валидацией и управлением, подробно разрабатываются IDP, уровни автономии, зрелость и организационная трансформация.
Классификация:
A — AWS AI-DLC как предшествующая схема AI-driven lifecycle;
B — адаптация предшествующей схемы через двухпетлевую организацию процесса;
C — соединение двух петель со сквозной валидацией, управлением, IDP, уровнями автономии, моделью зрелости и организационной трансформацией.
Таким образом, AWS AI-DLC выступает установленным архитектурным предшественником AI-Disrupt, но эта связь относится к общей организации жизненного цикла и сама по себе не определяет степень самостоятельности конструкции Сбера.
4.4. Mob Elaboration
В AI-Disrupt Mob Elaboration — это ограниченная по времени совместная проработка задачи с участием продуктового руководителя, инженерного лидера, нескольких опытных разработчиков и ИИ. В рамках этого предлагается длительность 60–90 минут. Сам термин и связанная с ним практика коллективного уточнения с ИИ уже присутствуют в AWS AI-DLC 2025 года. Это более близкий предшественник, чем общее сходство с рабочими сессиями или mob programming.
В AI-Disrupt конкретизируется состав, входы, выходы и положение сессии после Discovery.
Классификация:
A — Mob Elaboration как предшествующая практика AWS AI-DLC;
B — адаптация состава, входов, выходов и положения сессии в процессе;
C — включение адаптированной практики в архитектуру Intent Loop;
E — рекомендуемые состав и длительность сессии.
4.5. Intent Loop и Implementation Loop
Разделение работы с намерением, реализации и проверки существовало до AI-Disrupt. Наиболее близким из рассмотренных предшественников является AWS AI-DLC. Однако функциональное сходство стадий еще не означает существования идентичной двухпетлевой модели. Конструкцию Сбера отличают разные скорости петель, сохранение человеческой ответственности за намерение, доминирующая роль агентов в реализации и сквозной характер ограничений.
В полной версии есть внутренние итерации тестирования и исправления, межсессионные контрольные точки и возврат к постановке и спецификации. Следовательно, модель нельзя корректно описать как одностороннюю передачу окончательного задания от человека машине.
Классификация:
A — предшествующее разделение функций намерения, реализации и проверки;
B — его адаптация к агентному исполнению;
C — организация этих функций в две петли со сквозными ограничениями;
D — кандидат для точной композиции двух петель;
E — тезис о доминирующем переносе ограничения в Intent.
Достаточно близкий предшественник именно этой композиции в проведенном мной исследовании не установлен. Однако это позволяет говорить только о возможной самостоятельности композиции, но не об историческом приоритете Сбера или оригинальности всех ее составляющих.
4.6. Specification-Driven Development
Kiro при запуске 14 июля 2025 года уже описывал работу со структурированными требованиями, проектированием и задачами. GitHub, представляя Spec Kit 2 сентября 2025 года, прямо описывал спецификацию как источник истины: она задавала требования к системе, а реализация создавалась на ее основе. Таким образом, принцип спецификации как авторитетного источника был публично сформулирован до появления AI-Disrupt.
AI-Disrupt соединяет SDD с корпоративным legacy, уровнями спецификации, архитектурными контрактами, Evidence Bundle и Outcome Check.
Классификация:
A — SDD и принцип авторитетной спецификации как предшествующая практика;
B — их адаптация к корпоративной агентной разработке и существующим системам;
C — связь SDD с уровнями спецификации, архитектурными контрактами, Evidence Bundle и Outcome Check;
E — предпочтительность и обязательность отдельных режимов SDD.
Отличие AI-Disrupt здесь состоит не в самом принципе specification as source of truth, а в его месте и связях внутри общей архитектуры.
4.7. IDP и platform engineering
Whitepaper CNCF о платформах 2023 года документирует внутреннюю платформу как продукт для разработчиков: общие возможности, самообслуживание и снижение когнитивной нагрузки. Таким образом, основные принципы внутренней платформы разработки существовали до AI-Disrupt.
В AI-Disrupt Integrated Development Platform дополнена agent runtime (средой исполнения агента), инфраструктурой контекста и спецификаций, ModelOps/AgentOps (управлением жизненным циклом и эксплуатацией моделей и агентов), шлюзом моделей, агентными протоколами, evals, аудитом и FinOps (управлением расходами на работу среды). Не каждый из этих компонентов изначально возник в AI-Disrupt. Особенность конструкции Сбера состоит в том, как они объединены и какую роль получают в общей платформе разработки.
Классификация:
A — Internal Developer Platform и основные практики platform engineering как предшествующая основа;
B — их адаптация к работе людей и агентов в общей среде разработки;
C — объединение agent runtime, инфраструктуры контекста и спецификаций, ModelOps/AgentOps, модельного шлюза, агентных протоколов, evals, аудита и FinOps в составе Integrated Development Platform;
E — заявленные сроки построения IDP и ожидаемая окупаемость инвестиций;
F — заявленный рост производительности продуктовых команд на 30–50%.
Использование авторами AI-Disrupt названия Integrated Development Platform вместо распространенного в platform engineering Internal Developer Platform само по себе не означает появления нового класса платформ, но отражает более широкую роль, которую авторы отводят IDP в своей архитектуре.
4.8. Golden Paths
Spotify описывал Golden Paths в 2020 году как поддерживаемые пути выполнения типовой инженерной работы. Их функция — уменьшать фрагментацию и стоимость выбора при сохранении возможности обоснованного отклонения.
AI-Disrupt переносит эту практику на агентное исполнение и прослеживаемость от требования до выпуска. Паттерн становится одновременно способом доставки, носителем контекста и ограничений.
Классификация:
A — Golden Paths как предшествующая практика platform engineering;
B — ее адаптация к агентному исполнению и сквозной прослеживаемости;
C — включение Golden Paths в общую архитектуру IDP как носителя контекста и ограничений.
Количество шаблонов само по себе не определяет полноту библиотеки: она зависит от того, насколько эти шаблоны покрывают реальные задачи и исключения.
4.9. Policy as Code, Compliance as Code и DevSecOps
Встроенные проверки безопасности и формализованные политики применялись в разработке ПО до появления AI-Disrupt и независимо от агентного подхода. NIST SSDF 1.1, опубликованный в феврале 2022 года, включает практики безопасной разработки в жизненный цикл. Публикация CNCF об Open Policy Agent 2020 года описывает машиноисполняемые политики и отделение принятия решения от его применения.
Policy as Code позволяет представить правила в машиноисполняемой форме, а runtime enforcement применяет их при выполнении действий. Continuous compliance отвечает за регулярную проверку соответствия, тогда как Compliance as Code связывает требования с проверками и свидетельствами их выполнения. Эти функции пересекаются, но не тождественны. Перевод требований в машиноисполняемую форму при этом не гарантирует ни правильности их интерпретации, ни полноты покрытия.
AI-Disrupt адаптирует эту традицию к действиям агентов, динамическим полномочиям, бюджетам и журналам сессий.
Классификация:
A — встроенные проверки безопасности, Policy as Code и практики непрерывного контроля соответствия как предшествующие подходы;
B — их адаптация к действиям агентов, динамическим полномочиям, бюджетам и журналам сессий;
C — объединение этих механизмов в сквозную систему управления и контроля AI-Disrupt;
E — достаточность предусмотренного набора автоматизированных механизмов для обеспечения соответствия требованиям.
Наличие этих механизмов в архитектуре само по себе не подтверждает соответствие конкретным нормативным требованиям: такая оценка требует отдельного анализа применимых норм и их реализации.
4.10. Governance Mesh
Governance Mesh объединяет управление доступом и действиями, валидацию качества, аудит и комплаенс. Эти механизмы должны быть встроены в процесс, учитывать уровень риска и сопровождать автономную работу агентов.
Отдельные элементы такого управления существовали и до публикации AI-Disrupt. Microsoft Agent Governance Toolkit от 2 апреля 2026 года включает runtime-контроль, управление идентичностью, ограничения исполнения и аудит. Таким образом, agent governance как архитектурная область предшествует AI-Disrupt, однако рассмотренный подход Microsoft не воспроизводит трехмерную модель Governance Mesh Сбера.
Классификация:
A — механизмы runtime-контроля, управления идентичностью, ограничения исполнения и аудита как предшествующие практики;
B — их адаптация к автономной работе агентов и управлению с учетом риска;
C — объединение политик и полномочий, валидации, аудита и комплаенса в единую Governance Mesh;
D — кандидат для конкретной схемы взаимосвязей Governance Mesh как целостной конструкции.
Достаточно близкого предшественника всей композиции Governance Mesh в рассмотренных источниках не установлено. При этом возможная самостоятельность этой композиции не означает новизны ее отдельных компонентов.
4.11. Guardian Agents
Gartner публично описал guardian agents 11 июня 2025 года. Таким образом, и сам термин, и общая идея использования отдельных агентов для надзора появились до AI-Disrupt. Прогноз Gartner о доле guardian agents на рынке к 2030 году при этом не является подтверждением эффективности такого контроля.
В AI-Disrupt Guardian Agents получают режимы наблюдения, перехвата и исправления, а также шкалу вмешательств T1–T5 — от review до remediation. При этом Guardian Agent сам остается частью системы контроля полномочий и оценивания.
Классификация:
A — guardian agents и общая функция агентного надзора как предшествующая практика;
B — их адаптация через режимы наблюдения, перехвата и исправления и шкалу вмешательств T1–T5;
C — включение Guardian Agents в общую систему полномочий, оценивания и управления AI-Disrupt;
E — достаточность предусмотренных режимов и порогов вмешательства.
Таким образом, ни термин Guardian Agent, ни сама идея агента-контролера не являются собственными конструкциями AI-Disrupt. Отличительной особенностью здесь выступает их конкретная роль и интеграция в общую архитектуру.
4.12. Validation Spine
Непрерывные автоматизированные проверки появились еще задолго до агентной разработки. Описание Continuous Integration Мартина Фаулера восходит к 2000 году и позднее неоднократно перерабатывалось. В контексте агентной разработки до появления AI-Disrupt было опубликовано руководство Anthropic по evals от 9 января 2026 года, в котором различаются тестовые задания, прогоны, оценивание и анализ трасс.
В AI-Disrupt Validation Spine придает этим проверкам другую архитектурную роль. Валидация становится сквозным механизмом для обеих петель, а ее результаты используются при принятии решения о возможности дальнейшего действия.
Классификация:
A — непрерывные автоматизированные проверки и evals как предшествующие практики;
B — их адаптация к агентной разработке и контролю дальнейших действий;
C — объединение проверок в сквозной механизм валидации обеих петель AI-Disrupt;
D — кандидат для Validation Spine как конкретной именованной конструкции и ее архитектурной роли;
E — связанные с Validation Spine инвестиционные и временные нормативы.
Достаточно близкого предшественника Validation Spine именно в такой архитектурной роли в проведенном поиске мной не обнаружено. Это позволяет рассматривать саму конструкцию как возможный авторский вклад AI-Disrupt, но не распространяет этот вывод на составляющие ее практики непрерывной валидации.
4.13. Evidence Bundle
Тестовые отчеты, журналы, аттестации и provenance — сведения о происхождении и цепочке создания артефактов — существовали до AI-Disrupt. in-toto, представленный на USENIX Security в 2019 году, формализует проверяемые сведения о цепочке создания ПО. Само выражение Evidence Bundle также встречается раньше, например, в проекте IETF июля 2024 года о CSR attestation, однако используется там в другом предметном контексте.
В AI-Disrupt Evidence Bundle объединяет восемь составляющих, связывающих технический результат, качество, расходы, аудит, разрешения и будущую проверку продуктовой гипотезы. Вместе они образуют единый комплект свидетельств завершения работы.
Классификация:
A — тестовые отчеты, журналы, аттестации и provenance как предшествующие практики;
B — их адаптация к агентной разработке и подтверждению завершения работы;
C — объединение этих элементов в единый Evidence Bundle, связанный с техническим результатом, качеством, расходами, аудитом, разрешениями и Outcome Check;
D — кандидат для конкретного восьмикомпонентного состава Evidence Bundle и его функции как контракта завершения.
Достаточно близкого предшественника именно такой восьмикомпонентной конструкции в проведенном поиске мной не обнаружено. При этом более раннее использование выражения Evidence Bundle не устанавливает происхождение конструкции Сбера, а возможная самостоятельность ее композиции не означает новизны отдельных компонентов.
4.14. Agent autonomy ladders и R0–R5
Разделение способностей системы, предоставленных ей разрешений и человеческого надзора существовало и до AI-Disrupt. В непосредственном контексте ИИ-агентов исследование Anthropic об измерении автономии от февраля 2026 года рассматривает автономию через наблюдаемое поведение, длительность самостоятельной работы и взаимодействие с пользователем. Эти подходы предшествуют AI-Disrupt, однако не воспроизводят конкретную шкалу R0–R5 и не подтверждают ее как самостоятельную систему измерения.
В AI-Disrupt вопросы автономии, надзора и делегирования преобразованы в корпоративную систему разрешенной автономии и полномочий с учетом риска. R0–R5 задает конкретную лестницу допустимых действий, а доступный уровень может понижаться в зависимости от критичности, риска и сложности операции.
Классификация:
A — исследования автономии, человеческого надзора и делегирования как предшествующая основа;
B — их адаптация к корпоративной системе разрешений и risk-adaptive governance (управлению с учетом риска);
C — объединение автономии, полномочий, условий исполнения и надзора в единую систему разрешенной автономии;
D — кандидат для конкретной шкалы R0–R5 и правила определения доступного уровня;
E — установленные пороги и нормативные правила перехода между уровнями.
Поэтому R0–R5 будет точнее рассматривать как классы разрешенной автономии в определенных условиях исполнения, а не как одномерную шкалу способностей агента. Каждый уровень одновременно учитывает полномочия, среду исполнения, риск и длительность работы, поэтому сама структура R0–R5 еще не делает ее универсальной шкалой измерения автономии.
4.15. L0–L5
Модели зрелости как способ описания организационного развития существовали задолго до AI-Disrupt. Специфика L0–L5 у Сбера состоит в наборе критериев, связанных с регулярностью применения ИИ-практик, SDD, Evidence Bundle, длительной автономией, параллельной работой агентов и межагентной координацией.
Классификация:
A — maturity model как предшествующая форма описания организационного развития;
B — адаптация этой формы к системе способностей и практик AI-Disrupt;
C — объединение ИИ-практик, SDD, Evidence Bundle, автономии и межагентной координации в единую последовательность уровней;
D — кандидат для конкретной конфигурации уровней L0–L5 и их критериев;
E — обязательность предлагаемой траектории развития и нормативов перехода между уровнями.
L0–L5 характеризует зрелость освоения именно той системы способностей и практик, которую задает AI-Disrupt. Продвижение по шкале означает освоение большего числа предусмотренных ею элементов, но само по себе не подтверждает рост эффективности организации. Ссылки на другие модели зрелости также не являются независимой валидацией L0–L5. Связь более высокого уровня с лучшими внешними результатами требует отдельной эмпирической проверки.
4.16. Tiny Teams
Gartner в октябре 2025 года связывал AI-native development platforms с переходом к небольшим командам и прогнозировал изменение организационной структуры компаний к 2030 году. Таким образом, общая идея небольших команд, работающих с поддержкой ИИ, существовала до AI-Disrupt. Однако это не устанавливает происхождение конкретной организационной модели Tiny Teams Сбера.
В AI-Disrupt уменьшение размера команды связывается с общей IDP, длительными агентными сессиями, повторно используемыми паттернами и встроенной валидацией. В основной части рассматриваются команды из 3–6 человек, а в отдельных обобщениях используется диапазон 4–6 человек.
Классификация:
A — небольшие команды с поддержкой ИИ как предшествующая организационная идея;
B — ее адаптация к работе с общей IDP, длительными агентными сессиями, паттернами и встроенной валидацией;
C — объединение этих элементов в организационную модель Tiny Teams;
E — предполагаемая возможность замещения объема работы более крупной команды;
F — количественные утверждения о производительности и эквивалентности объема выполняемой работы.
Прогнозы изменения структуры команд подтверждают наличие соответствующего отраслевого ожидания, но не устанавливают эквивалентность производительности малых и более крупных команд. Такая эквивалентность требует отдельной эмпирической проверки для конкретных типов задач и условий работы.
4.17. Zero Friction
Сокращение времени ожидания, количества передач между функциями и когнитивной нагрузки относится к целям, которые уже присутствуют в непрерывной интеграции, platform engineering и self-service. AI-Disrupt переносит эти принципы в агентную разработку и объединяет их со встроенными проверками.
Классификация:
A — сокращение ожидания, передач между функциями и когнитивной нагрузки как предшествующие инженерные и организационные принципы;
B — их адаптация к агентному исполнению и встроенным проверкам;
C — объединение этих принципов в целевую организационную модель AI-Disrupt;
E — Zero Friction как нормативное целевое состояние.
Устранение отдельного этапа согласования не устраняет связанные с контролем затраты. Они могут перемещаться в проектирование и поддержку политик, тестирование, обработку исключений и работу платформенной команды. Поэтому Zero Friction точнее рассматривать как архитектурный ориентир на сокращение организационных разрывов и ожидания, а не как установленное отсутствие задержек и координационных затрат.
При таком понимании Zero Friction не противоречит человеческому согласованию с учетом риска. Если необходимые человеческие решения встроены непосредственно в рабочий поток, их наличие совместимо с сокращением очередей, передач работы и отдельных этапов согласования. По этой же причине Zero Friction и R0–R5 могут сосуществовать в одной архитектуре: формулировка «без согласований» не означает полного исключения человеческих решений.
4.18. Harness и Environment > Model
Anthropic описал эффективные harness для длительно работающих агентов в ноябре 2025 года: сохранение состояния, подготовка окружения и перенос работы между сессиями применялись до появления AI-Disrupt. Материал по context engineering сентября 2025 года также показывает, что проектирование и управление контекстом уже рассматривались как отдельная инженерная задача.
В AI-Disrupt среда становится одним из центральных объектов корпоративного инвестирования и связывается с управлением, памятью и повторным использованием. Отдельно авторы формулируют принцип Environment > Model, согласно которому развитие окружения может давать больший эффект, чем переход на более совершенную модель.
Классификация:
A — harness и context engineering как предшествующие инженерные практики;
B — их адаптация к корпоративной агентной разработке;
C — объединение окружения, контекста, памяти, управления и повторного использования в общей архитектуре AI-Disrupt;
E — принцип Environment > Model как утверждение о приоритетности инвестиций в среду;
F — количественные утверждения о превосходстве эффекта от улучшения среды над эффектом от смены модели.
Архитектурная значимость окружения и количественное неравенство Environment > Model относятся к разным утверждениям. Для первого существуют близкие предшественники, тогда как второе требует сопоставимого измерения эффекта от изменения среды и смены модели и отдельно рассматривается далее.
Проведенное сопоставление показывает, что происхождение AI-Disrupt нельзя определить только по наличию или отсутствию предшественников отдельных элементов. Для значительной части составляющих такие предшественники установлены, однако это само по себе ничего не говорит о происхождении их конкретной комбинации. Поэтому дальнейший анализ переходит от отдельных элементов к способам их адаптации, архитектурным связям и конструкциям, для которых достаточно близкие предшественники в проведенном поиске не установлены.
5. AWS AI-DLC и AI-Disrupt: сходства и различия
Сходство AI-Disrupt с AWS AI-DLC важно не только с точки зрения хронологии. Полная версия AI-Disrupt сама включает AI-DLC в сравнительный анализ и выделяет собственные отличия: обязательный Discovery, разделение спецификаций традиционного ПО и агентных продуктов, а также сквозную валидацию. Поэтому AI-DLC можно рассматривать как известный авторам предшествующий подход, а сходство между двумя конструкциями не приходится устанавливать только по совпадению отдельных принципов и терминов. Полная версия, § 2.3, с. 31–35.
| Измерение | AWS AI-DLC в публикации 2025 года | AI-Disrupt в изучаемой редакции |
|---|---|---|
| Начальная постановка | Business intent | Intent с обязательным Discovery и Outcome Hypothesis |
| Группировка жизненного цикла | Inception, Construction, Operations | Две петли и сквозные механизмы |
| Коллективное уточнение | Mob Elaboration | Конкретизированная сессия после Discovery |
| Роль ИИ | Центральный участник | Агентное исполнение на общей платформе |
| Роль человека | Критические решения и проверка | Владение намерением, архитектурные решения, исключения и полномочия |
| Контекст | Сохраняемые артефакты | Платформенная инфраструктура контекста и спецификаций |
| Развернутая организационная конструкция | Не предмет подробного описания стартовой публикации | Tiny Teams, роли, платформенная команда, L0–L5, программа трансформации |
Описание AWS в таблице основано на официальном представлении AI-DLC. Если какой-либо элемент не описан в этой публикации, из этого нельзя делать вывод о его отсутствии в других материалах или последующих реализациях AWS.
Основное различие между двумя подходами состоит в уровне и способе архитектурной детализации. AI-Disrupt связывает постановку и реализацию с корпоративной платформой, полномочиями агентов, доказательствами выполнения и организационной структурой. В результате предметом сравнения становится уже не только последовательность фаз разработки, но и более широкая система организации агентной разработки.
При этом сравнительная таблица самого Сбера отражает авторскую интерпретацию AI-DLC. Например, явно выделенная в AI-Disrupt роль сквозной валидации не означает отсутствия встроенного контроля в AWS. Аналогично обязательный Discovery в AI-Disrupt не означает, что AI-DLC начинает работу без выяснения бизнес-намерения. Поэтому при сравнении важно различать наличие самой функции, степень ее детализации и архитектурную роль, которую она получает в каждом подходе.
В пределах рассмотренных источников AI-DLC выступает документированным близким предшественником AI-Disrupt. При этом AI-Disrupt развивает собственную корпоративную композицию вокруг ряда общих принципов и дополняет ее платформенными, контрольными и организационными механизмами. Поэтому доступные источники не позволяют ни свести AI-Disrupt к AI-DLC, ни рассматривать общие для двух подходов принципы как независимо возникшие элементы AI-Disrupt.
6. Specification-Driven Development в AI-Disrupt
6.1. Два разных режима
Specification-centric development предполагает, что спецификация играет центральную координационную роль в разработке. Specification as authoritative source of truth задает более сильное правило: нормативное намерение системы определяется спецификацией, а реализация должна оставаться с ней согласованной. В первом случае спецификация может быть центральным рабочим артефактом, не становясь окончательным источником истины. Во втором необходим механизм разрешения расхождений между спецификацией и реализацией.
Близкий предшественник более сильного подхода присутствует в первоначальном описании GitHub Spec Kit. Поэтому сам принцип авторитетной спецификации существовал до AI-Disrupt. При этом общий принцип еще не определяет конкретный способ его реализации: организации могут по-разному задавать состав спецификации, степень ее исполнимости и допустимые отклонения.
Полная версия AI-Disrupt разделяет бизнес-, функциональные, технические и тестовые аспекты спецификации и допускает управляемую свободу реализации. Для существующей кодовой базы область применения также ограничена требуемыми изменениями, а не обязательно распространяется на весь продукт. Поэтому формулировку «код производен от спецификации» применительно к AI-Disrupt не следует понимать как требование полной перегенерации существующей enterprise-системы.
6.2. Спецификация и обратная связь от реализации
Спецификация может определять, какое изменение считается допустимым, но при этом оставаться неполным описанием реальной системы и ее окружения. В процессе реализации могут обнаружиться ограничения, которые не были известны заранее: несовместимость с контрактом legacy-системы, неоднозначность данных, недостаточная пропускная способность интеграции, непредвиденная стоимость вычислений или расхождение между ожидаемой и фактической семантикой внешнего сервиса.
Такие ситуации требуют разных решений. Если реализация расходится с корректной спецификацией, исправляется код. Если в самой спецификации обнаруживается пробел или противоречие, уточняется спецификация. Если же продуктовое намерение технически реализуемо, но его реализация оказывается экономически нецелесообразной, пересмотра требует уже решение о задаче. Только первый случай полностью укладывается в локальный цикл генерации и тестирования.
Поэтому процедура SDD должна позволять различать дефект реализации, дефект спецификации и опровержение продуктовой гипотезы. Это не эмпирически установленное свойство всех внедрений SDD, а необходимое условие непротиворечивой работы с авторитетной спецификацией.
6.3. Возврат от Implementation к Intent
В § 2.1 полной версии AI-Disrupt прямо предусмотрена возможность дополнения постановки и спецификации по результатам реализации. Процедура SDD также допускает обновление спецификации, а данные, полученные при эксплуатации, возвращаются в последующие решения. Поэтому Implementation Loop в AI-Disrupt нельзя рассматривать как процесс, который получает неизменный Intent и не способен вернуть в него новое знание.
При этом наличие обратной связи еще не определяет правила ее работы. Остаются вопросы о том, кто оценивает значимость нового знания, в каких случаях агент должен остановить выполнение, кто может изменить критерий приемки, как сохраняется история таких решений и как разрешается конфликт между фактическим поведением legacy-системы и желаемым контрактом.
Особенно здесь важны два вопроса: что служит условием возврата из Implementation Loop в Intent Loop и кто обладает полномочиями изменить Intent, Outcome Hypothesis или критерий приемки после обнаружения новой информации. Самой возможности такого возврата недостаточно. Необходимо определить, какое новое знание требует перехода на уровень Intent и кому принадлежит соответствующее решение. Без этих правил распределение ответственности между человеком и агентом остается определенным только на уровне общей архитектуры.
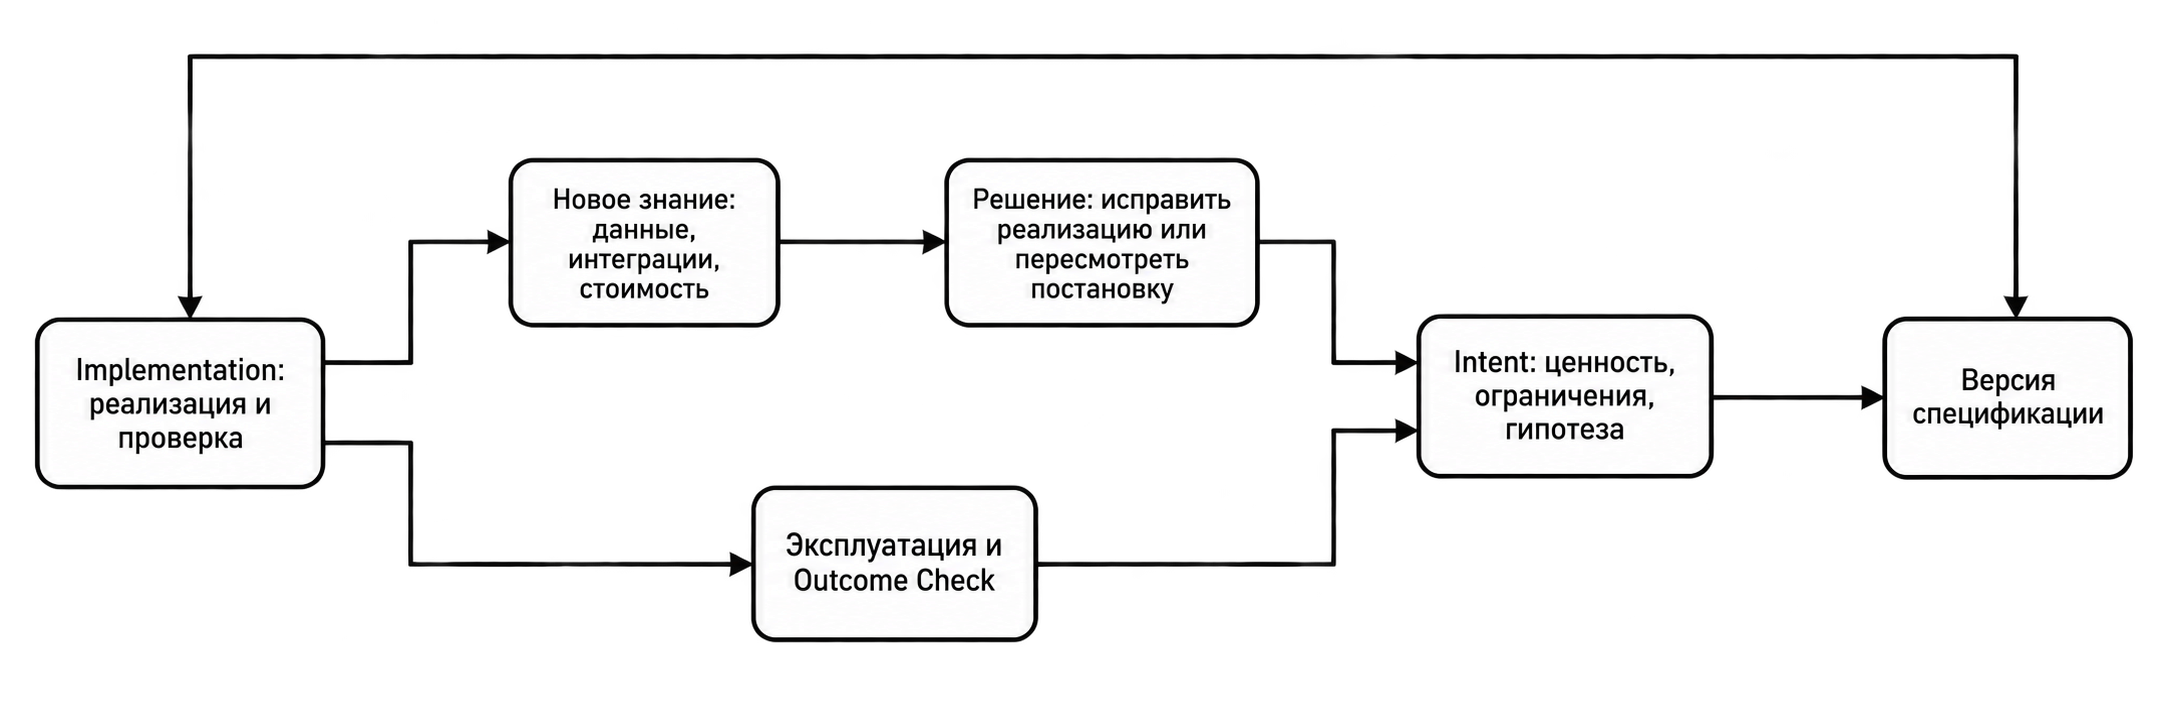
Эта схема представляет собой мою аналитическую реконструкцию обратной связи, а не воспроизведение авторской диаграммы. Она показывает, что двухпетлевая модель допускает изменение постановки и спецификации на основе знания, полученного в ходе реализации. Ограничение возникает не из-за разделения на две петли как такового, а в тех случаях, когда Intent на практике интерпретируется как полностью известный и неизменный вход.
7. Platform engineering и экономика общей среды
В полной версии AI-Disrupt IDP описана как единая операционная среда, включающая пятнадцать функциональных возможностей. Они сгруппированы вокруг исполнения и оркестрации, работы с контекстом и спецификациями, контроля качества, жизненного цикла моделей и агентов, а также governance, security и FinOps. Такая структура определяет основные направления платформенной работы. Полная версия, § 4.1, с. 72–73.
Появление agent runtime меняет требования к самой платформе. Интерфейса, рассчитанного на человека, может быть недостаточно для агента, которому необходимы однозначно определенные инструменты, машиночитаемые ограничения и возможность восстановления состояния. Инфраструктура контекста повышает требования и к актуальности документации: устаревшая информация может последовательно воспроизводиться в автоматических действиях. ModelOps и AI Gateway создают отдельные точки управления версиями моделей, маршрутизацией, доступом и стоимостью, а агентные протоколы обеспечивают взаимодействие между инструментами и исполнителями.
Поэтому предоставление командам доступа к отдельным ИИ-инструментам или лицензиям не равнозначно внедрению всей архитектуры AI-Disrupt. Однако из этого не следует, что построение собственной полноценной IDP всегда экономически предпочтительнее закупки готовых возможностей. Такое решение требует отдельного расчета. Повторное использование компонентов может снижать удельную стоимость при достаточном спросе и устойчивости самой платформы, но обновление моделей, интеграций, политик и evals одновременно создает постоянные эксплуатационные расходы.
В руководстве приводятся ориентиры в 12–18 месяцев на первоначальное построение IDP силами команды из 3–5 инженеров и PM. Эксплуатационные расходы оцениваются примерно в 30–50% первоначальных инвестиций, а срок окупаемости при обслуживании десяти и более команд — в 12–24 месяца. Эти значения имеют статус плановых ориентиров: опубликованные материалы не содержат методики расчета, распределения результатов проектов и состава учитываемых затрат в объеме, достаточном для независимой проверки переносимости этих оценок.
При оценке Tiny Teams необходимо учитывать и организационный периметр. Небольшая продуктовая команда может опираться на общую IDP, platform engineering, security, governance, инфраструктуру данных, ModelOps/AgentOps и эксплуатационные функции. Такое распределение работы совместимо с моделью Tiny Teams, но численность отдельной продуктовой команды нельзя напрямую сопоставлять с полной численностью или стоимостью прежней команды без приведения сравниваемых вариантов к одинаковому организационному периметру.
8. Governance, Validation Spine и Evidence Bundle
8.1. Место Validation Spine в Governance Mesh
В обзорном представлении Intent Loop, Implementation Loop, Validation Spine и Governance Mesh показаны как четыре различимых элемента. При этом в § 2.12–2.13 Validation Spine описана как качественное измерение Governance Mesh наряду с политиками и полномочиями, а также аудитом и комплаенсом. Полная версия, с. 49–52.
Эти два представления можно согласовать, если обзорная схема показывает функциональные роли, а подробное описание определяет отношения между ними. Validation Spine в таком случае может быть достаточно значимым для самостоятельного отображения и одновременно входить в более широкую систему Governance Mesh. Само по себе такое двойное положение не создает архитектурного противоречия.
Неоднозначность возникает, если воспринимать все четыре элемента обзорной схемы как независимые и однопорядковые контуры. При переходе к реализации необходимо определить отношения между ними на уровне конкретных решений и полномочий. Например, отрицательный результат eval может означать запрет на дальнейшее действие, рекомендацию Guardian Agent или необходимость человеческой эскалации. Аналогично требуется определить, где фиксируется окончательное разрешение на выпуск и кто обладает полномочиями изменить соответствующую проверку.
Подробное описание AI-Disrupt позволяет уточнить часть этих отношений, однако обзорная схема сама по себе не определяет их полностью.
8.2. Границы автоматизированной проверки
В AI-Disrupt значительная роль отводится детерминированным проверкам, в том числе создаваемым с помощью LLM. Детерминированность делает результат проверки воспроизводимым, но не гарантирует корректность самого проверяемого правила. Такая проверка может стабильно подтверждать неверное требование, не охватывать важный класс состояний или использовать некорректно подготовленные данные.
Поэтому необходимо различать воспроизводимость выполнения проверки, полноту ее покрытия и соответствие реальной задаче. Воспроизводимость относится к процедуре проверки, полнота покрытия зависит от выбранного пространства случаев, а соответствие задаче определяется корректностью постановки и критериев. Автоматизация проверки сама по себе не обеспечивает наличие всех трех свойств.
То же ограничение относится к независимости проверки. Использование отдельного reviewer agent не гарантирует независимости его оценки, если генератор и проверяющий опираются на одну ошибочную спецификацию. В таком случае они могут согласованно подтвердить результат, который соответствует спецификации, но не соответствует реальной задаче.
Это ограничение следует из самой структуры такого механизма и не свидетельствует о фактической ошибке Validation Spine в AI-Disrupt. Оно определяет границу того, что можно обеспечить детерминированностью и разделением ролей между агентами.
8.3. Что доказывает Evidence Bundle
Evidence Bundle позволяет установить, какие действия были выполнены, какие проверки запускались и какие разрешения действовали в процессе работы. При наличии надежной связи с конкретными версиями артефактов он обеспечивает прослеживаемость завершенного изменения. При этом доказательный статус входящих в него элементов различается.
Diff подтверждает наличие конкретного изменения, успешный тест показывает прохождение определенной проверки, аттестация фиксирует решение соответствующего механизма, а журнал отражает зарегистрированную последовательность событий в пределах полноты регистрации. Ни один из этих элементов сам по себе не подтверждает полноту требований, отсутствие всех возможных дефектов или достижение ожидаемого бизнес-результата.
Отдельное значение имеет временная граница между завершением разработки и проверкой продуктовой гипотезы. Evidence Bundle может быть сформирован до накопления данных, необходимых для Outcome Check. В этом случае ссылка на будущую проверку фиксирует обязательство провести измерение, но еще не подтверждает саму гипотезу. Результат Outcome Check должен появиться позднее и иметь собственное доказательное основание.
Такая последовательность совместима с архитектурой AI-Disrupt при условии, что завершение разработки и подтверждение ожидаемого эффекта рассматриваются как разные статусы.
8.4. Соотношение инвестиций в Validation и Implementation
Руководство рекомендует направлять на Validation Spine не менее 0,5 от объема инвестиций в Implementation и устанавливает временные ориентиры для выполнения проверок. Эти значения представляют собой нормативные рекомендации авторов. Публичной калибровки, которая подтверждала бы оптимальность такой доли для разных классов систем, не приведено.
При этом доля инвестиций сама по себе не определяет пропускную способность Validation Spine. Ускорение генерации может сопровождаться ростом объема случаев, которые трудно автоматизировать, поэтому одинаковое соотношение инвестиций способно приводить к разной нагрузке и разным очередям проверки. На достаточную мощность валидации влияют распределение сложности, частота исключений, качество тестовых оракулов и стоимость ошибки.
Поэтому предложенное соотношение можно рассматривать как ориентир для планирования инвестиций в Validation Spine, но не как установленную универсальную пропорцию. Его достаточность для конкретной системы зависит от характеристик потока изменений и требуемого уровня контроля.
9. Ограничение разработки и роль Intent
Тезис AI-Disrupt о переносе ограничения к Intent допускает два прочтения. В более узком смысле снижение стоимости реализации повышает относительную значимость постановки задачи. В более сильной интерпретации Implementation перестает быть ограничением, а качество Intent становится главным ограничением разработки в целом. Второе утверждение не следует непосредственно из первого.
Ускорение генерации кода и других артефактов реализации может изменить соотношение времени и затрат между различными стадиями разработки. В результате ограничение способно сместиться к постановке задачи, проверке, интеграции, governance, инфраструктуре или другим участкам процесса. При этом ускорение производства артефактов не означает, что Implementation как целая система перестает быть возможным ограничением: генерация составляет только часть работы, выполняемой внутри нее.
Это можно показать на условном примере. Если сквозной срок состоит из 10 дней согласования, 10 дней реализации и 10 дней интеграции и проверки, его исходная продолжительность составляет 30 дней. Пятикратное ускорение реализации сокращает соответствующий этап до 2 дней, но весь цикл только до 22 дней. Сквозной срок уменьшается примерно на 26,7%, а скорость прохождения всего цикла возрастает примерно в 1,36 раза. Этот пример показывает, почему локальный коэффициент ускорения нельзя непосредственно переносить на весь PDLC.
| Возможное ограничение | Почему ускорение генерации его не устраняет автоматически |
|---|---|
| Stakeholder alignment | Участники могут иметь несовместимые цели и критерии успеха |
| Legacy | Неявные контракты и накопленные зависимости требуют обнаружения и согласования |
| Архитектура | Изменение границ и общих решений может затрагивать несколько продуктов |
| Интеграции | Внешние системы имеют собственные сроки и ограничения |
| Доступность данных | Отсутствующие, неполные или несогласованные данные нельзя компенсировать скоростью генерации |
| Регуляторные требования | Часть решений требует интерпретации требований, формирования свидетельств и установленной ответственности |
| Организационные полномочия | Право изменить процесс или принять риск может находиться за пределами команды |
| Неопределенность | Часть задач требует исследования до того, как становится возможным их исполнение |
| Верификация | Скорость создания результата может превышать способность проверить его корректность |
Часть этих ограничений можно отнести к Intent, если использовать достаточно широкое определение этого понятия. Однако по мере расширения определения тезис о переносе ограничения к Intent становится труднее проверить эмпирически, поскольку к нему начинают относиться различные причины задержек за пределами непосредственного исполнения. Для проверки такой гипотезы необходимо заранее определить границы Intent и отделить связанные с ним задержки от ограничений других стадий PDLC.
Сам AI-Disrupt дает основания для более узкой интерпретации исходного тезиса. Авторы различают типы задач, сохраняют несколько режимов применения ИИ и отдельно предусматривают Discovery, архитектурные решения и валидацию. Поэтому перенос ограничения к Intent точнее рассматривать как контекстную причинную гипотезу: в одних потоках работ основное ограничение действительно может сместиться к постановке задачи, тогда как в других им останутся интеграция, верификация, инфраструктура или иная часть процесса.
10. Шкалы R0–R5 и L0–L5
10.1. Интерпретация уровней R0–R5
В подробном описании R0 означает чтение без возможности изменения, R1 позволяет агенту формировать предложения, принимаемые человеком, R2 предусматривает работу в отдельной ветке с последующим review, R3 допускает автоматическое слияние при соблюдении заданных условий, R4 предполагает многосессионную работу с контрольными точками, а R5 позволяет проводить автономные эксперименты в песочнице. При этом один и тот же агент может иметь разные уровни в зависимости от среды исполнения. Полная версия, § 4.3, с. 93–95.
Краткое описание в глоссарии менее точно передает крайние уровни шкалы: формулировки о предложениях на R0 и автономии в домене на R5 не полностью совпадают с подробной таблицей. При практической интерпретации R0–R5 детализированное описание разрешений дает более полное представление о содержании уровней, при этом расхождение между двумя описаниями сохраняется как редакционная неоднозначность.
R0–R5 точнее рассматривать как классы разрешенной автономии, учитывающие полномочия, риск и условия исполнения. Способности агента, предоставленные ему права, необходимость человеческого согласования и характеристики среды являются разными параметрами, тогда как R0–R5 объединяет их с допустимой длительностью самостоятельной работы. Поэтому более высокий уровень не обязательно соответствует большему риску. Например, автономный эксперимент в изолированной песочнице может создавать меньший риск, чем более ограниченное действие в production. По этой причине R0–R5 нельзя интерпретировать как универсальную одномерную шкалу автономности или интервальную шкалу риска без дополнительной модели.
Предлагаемое правило понижения доступного уровня автономии записывается следующим образом:
effective_R = nominal_R − criticality − risk − complexity
Каждая поправка принимает значение 0, 1 или 2 и учитывает условия конкретной операции. При этом арифметические операции применяются к порядковым категориям. В рассматриваемом описании не приведено обоснование одинакового веса трех поправок и однозначное правило обработки результата, выходящего за границы шкалы R0–R5. Эти параметры требуют дополнительного определения при реализации, но не меняют самого принципа адаптивного ограничения разрешенной автономии.
10.2. Интерпретация уровней L0–L5
L0–L5 одновременно описывает наблюдаемые практики и задает направление развития. На ранних уровнях различаются отсутствие системной практики, использование отдельных ИИ-помощников и регулярная автоматизация. На следующих уровнях появляются SDD, Evidence Bundle, длительные и параллельные агентные сессии. L5 связан с координированной работой нескольких агентов, а переход к нему включает A2A, протокол межагентного взаимодействия. Полная версия, § 3.6, с. 68–71.
У модели есть две связанные функции. Диагностическая отвечает на вопрос, какие способности и практики уже присутствуют в организации. Нормативная определяет состояние, к которому предполагается двигаться. Эти функции могут сосуществовать в одной модели, однако ни одна из них сама по себе не является измерением эффективности.
По форме L0–L5 представляет собой модель зрелости (maturity model). Сама эта форма существовала до AI-Disrupt, что ничего не говорит о происхождении конкретного содержания его уровней. L0–L5 характеризует степень освоения целевой системы способностей и практик AI-Disrupt: продвижение по шкале означает освоение большего числа предусмотренных ею элементов. Эту характеристику необходимо отличать от независимо подтвержденной эффективности.
Например, организация может достигать высоких бизнес-результатов, обеспечивать устойчивую эксплуатацию и короткое время поставки, но сознательно использовать простую оркестрацию без межагентного взаимодействия. По критериям AI-Disrupt такая организация может не соответствовать L5. Это означает отсутствие предусмотренного моделью архитектурного признака, но само по себе не свидетельствует о меньшей эффективности.
Поэтому L0–L5 прежде всего характеризует развитие способностей в направлении целевой архитектуры AI-Disrupt. Более сильная интерпретация, при которой высокий уровень L означает более высокую эффективность разработки независимо от используемой архитектуры, требует отдельной эмпирической проверки связи уровней с внешними показателями: outcomes (результатами изменений), reliability (надежностью), а также delivery performance (скоростью и стабильностью поставки изменений). При такой проверке необходимо учитывать различия между задачами и организациями.
Это ограничение согласуется и с частью авторских оговорок. Руководство описывает модель как инструмент планирования, а не как показатель статуса, и допускает параллельное существование разных режимов разработки. При этом нормативная функция L0–L5 сохраняется в тех случаях, когда продвижение к следующему уровню становится самостоятельной целью развития.
11. Организационная модель Tiny Teams
11.1. Tiny Team и трудоемкость
В основной части полной версии AI-Disrupt Tiny Team описывается как команда из 3–6 человек, способная выполнять объем работы, для которого ранее требовалось 15–20 участников. Такая модель предполагает наличие зрелой IDP, длительных агентных сессий, библиотеки как минимум из 30 паттернов, встроенной валидации и ADLC. Поэтому указанный размер команды относится к конкретной организационной модели и набору предпосылок, а не к произвольному сокращению существующей команды до 3–6 человек. Полная версия, § 3.4, с. 61–63.
Для сравнения Tiny Team с более крупной командой необходимо использовать одинаковый организационный периметр. В него могут входить продуктовая разработка, сопровождение, безопасность, архитектура, governance, инфраструктура данных, ModelOps/AgentOps, а также соответствующая доля работы общей IDP и platform engineering. Если часть функций переносится из продуктовой команды в общую платформенную или инфраструктурную службу, сокращение численности самой продуктовой группы и сокращение полной трудоемкости становятся разными показателями.
При этом вынесение общих функций на уровень платформы может создавать экономию масштаба и само по себе не исключает заявленного эффекта Tiny Teams. Для его оценки необходимо сопоставлять не только численность продуктовых команд, но и полный объем ресурсов, необходимых для выполнения сравниваемого объема работы.
11.2. Соотношение junior и senior в модели Tiny Teams
В разделе о соотношении junior и senior руководство обращается к данным Wobo. Отчет Wobo за апрель 2026 года содержит 2 930 senior- и 212 junior-вакансий в выборке из семи компаний, что соответствует соотношению примерно 14:1. Для Netflix, Anthropic и OpenAI приводятся еще более высокие значения. Эти данные характеризуют структуру открытых вакансий выбранных компаний в определенный период, но не состав их инженерных команд или фактическую структуру найма.
Переход от наблюдаемой структуры вакансий к объяснению причин требует дополнительных оснований. Для этого необходимо учитывать репрезентативность выбранных компаний, различие между публикацией вакансии и фактическим наймом, программы найма выпускников вне обычных объявлений, а также отделять возможное влияние ИИ от особенностей бизнеса и стадии развития каждой компании. Даже устойчивая тенденция в структуре вакансий сама по себе не определяет оптимальную кадровую политику конкретной организации.
AI-Disrupt идет дальше наблюдаемой статистики и рекомендует нанимать меньше junior-специалистов, одновременно увеличивая объем наставничества для каждого из них. Это уже нормативная рекомендация авторов, которая непосредственно из приведенной статистики вакансий не следует.
В документе также сопоставляются традиционное соотношение junior/senior 3:1 и целевое 1:1. При этом внешняя статистика Wobo представлена в обратном отношении senior/junior и основана на другой единице наблюдения: количестве опубликованных вакансий. Поэтому значения 3:1, 1:1 и 14:1 нельзя интерпретировать как последовательные состояния одного показателя без дополнительных сопоставимых данных.
11.3. Воспроизводство senior-экспертизы
Сокращение притока junior-специалистов ставит вопрос о воспроизводстве senior-экспертизы. Она включает в себя не только способность создавать код, но и умение распознавать ошибки постановки, работать с неопределенностью, оценивать последствия архитектурных решений и принимать ответственность за эксплуатацию. Если значительная часть типовых задач передается агентам, возникает вопрос о том, на каких задачах и в каких условиях менее опытный специалист приобретает эти навыки.
AI-Disrupt учитывает эту проблему. Полная версия предусматривает наставничество, формальное обучение и постепенное освоение практики, в том числе на горизонте 12–18 месяцев. Поэтому сокращение найма junior в предлагаемой модели не означает отказа от их развития. При этом остается открытым вопрос, способны ли предусмотренные механизмы компенсировать сокращение притока junior-специалистов в долгосрочной перспективе на уровне отдельных организаций и отрасли в целом.
Контролируемое исследование Anthropic от января 2026 года показывает, что использование ИИ при освоении новой библиотеки в определенных условиях может снижать измеренное усвоение навыков, причем результат зависит от способа использования ИИ. Это дает основание рассматривать обучение и текущую производительность как разные показатели, но не определяет оптимальное соотношение junior и senior и не устанавливает наличие долгосрочного дефицита экспертов.
Таким образом, структура спроса на специалистов, текущая производительность, обучение и долгосрочное воспроизводство экспертизы представляют собой разные предметы анализа. Рассмотренные материалы позволяют определить предлагаемую AI-Disrupt кадровую модель, но не устанавливают универсальную структуру найма, обеспечивающую ее долгосрочную устойчивость.
Предыдущие разделы позволили отделить происхождение отдельных практик от способов их адаптации и композиции в AI-Disrupt, а также рассмотреть архитектурные и организационные вопросы на уровне системы в целом. Однако связность самой конструкции еще не определяет доказательный статус заявленных эффектов. Поэтому в разделах 12–16 мой анализ переходит к количественным, причинным и прогностическим утверждениям AI-Disrupt: их источникам, единицам измерения и границам обобщения.
12. Доказательная база AI-Disrupt
12.1. Интерпретация результатов проверки утверждений
При проверке утверждений необходимо различать три уровня: подтверждение самого значения, подтверждение его интерпретации и подтверждение применимости результата к AI-Disrupt в целом. Исследование отдельного инструмента может подтверждать локальный эффект его применения, но этого недостаточно для подтверждения эффективности всей организационной архитектуры. Аналогично аналитический прогноз подтверждает наличие опубликованного ожидания, но не является наблюдением прогнозируемого результата.
Статус «первичный источник не идентифицирован» означает, что в ходе проведенного мной поиска точную формулировку не удалось связать с доступным первичным источником, содержащим методику получения соответствующего результата. Это не означает отсутствия самого источника или внутренних данных, на которых может основываться утверждение. Однако общей ссылки на Gartner, Bain, Anthropic или другую организацию без указания конкретной публикации недостаточно для независимой проверки приведенного значения.
12.2. Проверка количественных утверждений
| Утверждение | Локализация в основном корпусе | Результат проверки и допустимый вывод |
|---|---|---|
| 53,8% → 81,8%; связь с 225 задачами | Полная версия, с. 2 и 50; внешний пример для аргумента о среде | Первичный материал DeepSense найден. Однако baseline 53,8% получен на 225 задачах, а результат 81,8% — на 33 Python-задачах. Источник не подтверждает рост с 53,8% до 81,8% на одной выборке из 225 задач |
| $0,04 → $0,61 за задачу | Полная версия, резюме | DeepSense приводит оба значения стоимости, их отношение составляет 15,25. Однако они относятся к разным выборкам задач, что ограничивает прямое сопоставление |
| Среда: 23% → 45%, +22 п. п. | Полная версия, § 1.2, с. 9 | Первичный источник, позволяющий установить модель, выборку и условия получения этих значений, не идентифицирован. Поэтому проверить величину эффекта и его причинную интерпретацию по доступным материалам нельзя |
| Разница лучших моделей 1–3 п. п. | Там же | Не определены сравниваемые модели, дата измерения, benchmark и вычислительный бюджет. Поэтому диапазон 1–3 п. п. нельзя интерпретировать как универсальную величину эффекта от смены модели |
| На 60% меньше дефектов после развертывания к 2028 году при развитой среде | Полная версия, § 1.6, с. 15–16 | Утверждение представлено как прогноз. Первичный источник и методика получения значения 60% в доступных материалах не идентифицированы; оно не является наблюдаемым результатом внедрения AI-Disrupt |
| На 25% ниже скорость без SDD к 2027 году | Там же | Утверждение относится к прогнозируемому отставанию от конкурентов, а не к абсолютному снижению скорости. Первичный источник с определением показателя скорости и методикой получения значения 25% не идентифицирован |
| Доля ручного кода 50% → 25% к 2028 году | Полная версия, резюме, с. 2 | Прогнозное утверждение. В доступном описании недостаточно определены знаменатель показателя и способ атрибуции кода, а точный первичный источник не идентифицирован |
| Прирост 11–25% при ИИ как дополнении | Полная версия, § 1.5 и § 1.7, с. 14–17 | Внешние исследования подтверждают наличие локальных и полевых эффектов от использования ИИ, однако единый универсальный диапазон 11–25% для этой категории по рассмотренным источникам не установлен |
| Прирост 25–50% при ИИ-нативном перепроектировании | Там же | Обобщенная оценка. В доступных материалах не представлен единый исследовательский дизайн, позволяющий отделить эффект самого режима от различий в задачах, командах и условиях применения |
| Прирост 30–50%+ при агентном подходе | Полная версия, § 1.5–1.6 | Прогностическая и обобщающая оценка. Общий измеритель, позволяющий непосредственно сопоставить этот диапазон с диапазонами 11–25% и 25–50%, не установлен |
| 2 000 / 3 000 / 5 000–8 000 / 15 000–25 000 строк в месяц | Полная версия, § 1.1, с. 7–8 | Авторы характеризуют значения как грубую иллюстрацию и ссылаются на внутренние наблюдения и внешние бенчмарки. Выборка и методика нормализации показателя в публичных материалах не приведены |
| 20 человеко-лет → 4–6 разработчиков × 3 месяца | Там же | Указанные значения соответствуют примерно 13,3–20-кратному сокращению трудоемкости. Публичная эмпирическая база для такого сопоставления не установлена |
| «Окно трансформации 12–18 месяцев» | В корпусе есть несколько разных употреблений срока | Единого универсального срока трансформации в материалах не установлено. Период 12–18 месяцев используется, в частности, для построения IDP, перехода L3→L4 и развития компетенций |
| 90% enterprise-инженеров используют ИИ-ассистентов к 2028 году, против менее 14% в начале 2024-го | Полная версия, § 1.6 | Первичный прогноз Gartner подтвержден. Он относится к ожидаемой распространенности использования ИИ-ассистентов, а не к величине эффекта от их применения |
| 80% организаций перейдут от крупных команд к меньшим ИИ-поддерживаемым командам к 2030 году | Полная версия, § 3.4 | Соответствующая формулировка присутствует в прогнозе Gartner 2025 года. Прогноз не устанавливает эквивалентность объема работы команд из 3–6 и 15–20 человек |
| 70%+ инженеров используют агентные инструменты; 70% уязвимостей устраняют агенты; 40% платформенных команд применяют ИИ во всех фазах | Полная версия, § 1.6 | Утверждения представлены как прогнозы. Первичные источники, позволяющие проверить все три значения и используемые определения показателей, в доступных материалах не идентифицированы |
| Product engineer заменяет 50%+ позиций; доля AI-custom приложений в портфелях достигает 40% против 2% | Там же | Прогнозные утверждения об изменении структуры работ и портфелей. Они не являются измеренными результатами внедрения AI-Disrupt |
| Tiny Team 3–6 человек выполняет объем прежней команды 15–20 | Полная версия, § 3.4 | Организационная оценка, предполагающая наличие зрелой IDP и других платформенных условий. Публичное сопоставимое исследование, подтверждающее указанную эквивалентность объема работы, не приведено |
| Output Volume Lift (рост объема инженерных артефактов) >2 — зрелая практика, >3 — исключительный результат | Полная версия, с. 122 | Значения используются как нормативные пороги. Внешняя эмпирическая калибровка границ >2 и >3 в рассмотренных источниках не установлена |
| Инвестиции в валидацию ≥0,5 инвестиций в реализацию | Полная версия, с. 49 | Нормативное соотношение инвестиций. Эмпирическое обоснование его оптимальности для разных классов систем в рассмотренных источниках не установлено |
| Окупаемость IDP 12–24 месяца при десяти и более командах | Полная версия, с. 72 | Плановая экономическая оценка. Полная модель денежных потоков, состав учитываемых затрат и распределение результатов в доступных материалах не приведены |
| Около 27% дополнительной «ценности» от фоновых/событийных агентов | Краткая версия, с. 43 | Ближайший найденный первичный результат Anthropic относится к доле задач, которые пользователи, по их собственным оценкам, иначе не выполнили бы. Этот показатель имеет более узкое значение и не эквивалентен 27% дополнительной «ценности» |
Для прогнозов об использовании ИИ-ассистентов и переходе к меньшим командам соответствующие формулировки найдены в публикации Gartner от 1 июля 2025 года и публикации Gartner о технологических трендах 2026 года. Эти источники подтверждают конкретные прогнозы, но не остальные количественные утверждения, приведенные в таблице.
12.3. Диапазоны производительности и их сопоставимость
В AI-Disrupt диапазоны 11–25%, 25–50% и 30–50%+ относятся к разным режимам работы и разной глубине перестройки процесса. Для их прямого количественного сравнения необходимо, чтобы во всех случаях измерялся один и тот же показатель по сопоставимой методике. Из опубликованного описания не следует, что эти диапазоны одинаковым образом отражают прирост числа завершенных задач, сокращение трудозатрат, изменение сквозного времени или другой показатель производительности.
Поэтому приведенные значения характеризуют заявленные авторами диапазоны для разных режимов работы, но не образуют установленную количественную зависимость, согласно которой переход от использования ИИ как помощника к SDD и далее к автономным агентам обеспечивает соответствующий прирост производительности. Внешние исследования подтверждают отдельные эффекты применения ИИ, но не всю последовательность диапазонов AI-Disrupt как единую эмпирическую зависимость.
Снижение времени на 25% и рост производительности на 25% также не равнозначны. При неизменном объеме работы сокращение времени до 75% исходного соответствует увеличению скорости примерно в 1,33 раза. В свою очередь, увеличение скорости на 25% соответствует сокращению времени до 80% исходного. Поэтому без точного определения измеряемого показателя даже численно близкие значения могут описывать разные эффекты.
Дополнительное ограничение возникает при сравнении разных организаций. Компании, способные провести глубокое перепроектирование процесса, могут исходно отличаться качеством данных, состоянием платформы, организацией разработки и другими условиями. Более высокий результат таких организаций сам по себе не позволяет определить, какая его часть связана именно с выбранным режимом применения ИИ. Тем более из такого наблюдения нельзя непосредственно вывести, что аналогичный переход обеспечит сопоставимый эффект в других организациях.
В отчете Bain 2025 года действительно рассматривается прирост производительности на 10–15% у команд, использующих ИИ-помощников, а также приводятся сообщения отдельных компаний о приросте на 25–30% при более глубокой трансформации процесса. Эти данные поддерживают различение локального применения ИИ и более широкого перепроектирования разработки, но не устанавливают точные границы диапазонов AI-Disrupt и не подтверждают их как единую количественную шкалу.
12.4. Эмпирические оценки эффектов применения ИИ
Результаты исследований GitHub Copilot, Accenture, Microsoft и METR относятся к разным показателям, выборкам, инструментам и условиям. Поэтому их нельзя рассматривать как измерения одной величины, объединять в общий диапазон или использовать для расчета средней оценки. Вместе они позволяют оценить, насколько наблюдаемый эффект зависит от контекста и способа измерения.
В контролируемом исследовании GitHub Copilot 2023 года участники выполняли конкретное задание по реализации HTTP-сервера с Copilot в среднем на 55,8% быстрее. Исследование подтверждает возможность существенного ускорения при выполнении отдельной задачи, но не измеряет производительность команды на длительном периоде, интеграцию enterprise-систем или эффект от изменения архитектуры процесса разработки.
Эксперимент GitHub и Accenture 2024 года показал рост доли успешных сборок на 84% среди участников, использовавших Copilot. Этот показатель характеризует конкретный результат процесса разработки, но не означает роста производительности на 84% и не позволяет сделать вывод о сопоставимом сокращении полной трудоемкости проекта.
Три полевых эксперимента с 4 867 разработчиками, опубликованные Microsoft Research в 2025 году, дали объединенную оценку роста числа завершенных задач на 26,08% при стандартной ошибке в 10,3 процентного пункта. Этот показатель получен в условиях реальной производственной работы, но относится к конкретным инструментам, организациям и способу определения завершенной задачи. Поэтому он не может непосредственно характеризовать эффект от внедрения AI-Disrupt в целом.
Исследование METR июля 2025 года охватывало 16 опытных разработчиков и 246 задач в знакомых им open-source-проектах. В этих условиях использование ИИ-инструментов увеличило время выполнения задач примерно на 19%. Результат показывает, что эффект может различаться не только по величине, но и по направлению, однако не позволяет сделать вывод, что применение ИИ в целом замедляет разработку. В обновлении METR от февраля 2026 года авторы отдельно рассмотрели влияние отбора задач и участников, а также изменений в способах использования ИИ. Поэтому результат эксперимента 2025 года нельзя непосредственно переносить на другие инструменты, задачи и периоды.
Рассмотренные исследования показывают существенную зависимость наблюдаемого эффекта от задачи, опыта разработчиков, используемого инструмента и дизайна измерения. Они подтверждают наличие измеримых эффектов применения ИИ в разработке, в том числе значительных в отдельных условиях, но не устанавливают единую величину эффекта для AI-Disrupt в целом.
12.5. Соотношение количества задач и создаваемой ценности
В кратком whitepaper показатель около 27% связывается с дополнительной ценностью фоновой агентной работы. В исследовании Anthropic об использовании ИИ внутри компании соответствующий результат имеет более узкое значение: сотрудники сообщили, что часть задач, выполняемых ими с помощью ИИ, без него не была бы выполнена. Таким образом, исходный показатель относится к доле дополнительных задач, а не к денежной или иной оценке создаваемой ими ценности.
Переход от количества дополнительных задач к их ценности требует учитывать значимость этих задач, затраты на их выполнение, доступные альтернативы и полученный результат. Дополнительный эксперимент и дополнительное исправление документации могут одинаково учитываться как выполненные задачи, но существенно различаться по стоимости и эффекту. Поэтому результат Anthropic подтверждает расширение объема выполняемой работы, но сам по себе не позволяет определить экономический эффект такого расширения.
13. Результаты DeepSense и их интерпретация
13.1. Результаты исследования DeepSense
Материал DeepSense от 18 марта 2025 года описывает агента на базе o3-mini, который выполняет несколько итераций генерации, review кода и запуска unit-тестов. Агент оценивался на 33 Python-задачах и показал результат 81,8%. Для сравнения приводится baseline o3-mini (medium) с результатом 53,8%, полученным на 225 задачах многоязычного набора Aider. Средняя стоимость выполнения задачи составляет соответственно $0,61 и $0,04.
Таким образом, 225 задач относятся к baseline, а не к оценке агентной системы. Первичный материал не подтверждает интерпретацию, согласно которой одна и та же модель улучшила результат с 53,8% до 81,8% на одной выборке из 225 задач. Использование o3-mini в обоих случаях также само по себе не устанавливает идентичность конфигурации модели, reasoning budget и протокола выполнения задач.
Поэтому опубликованные результаты показывают более высокий показатель агентной системы на использованной DeepSense выборке, но не позволяют интерпретировать разницу между 53,8% и 81,8% как измеренный причинный эффект среды. Для такой оценки потребовалось бы сравнение в сопоставимых условиях.
13.2. Разница в результатах и ее интерпретация
Опубликованные значения различаются на 28 процентных пунктов. Само арифметическое сравнение корректно, однако интерпретация этой разницы как эффекта среды требует сопоставимых условий. Поскольку результаты получены на разных выборках задач, на величину различия могли повлиять язык, сложность, распределение типов задач и критерии их отбора.
Использование одного семейства моделей исключает одну возможную причину различий, но не остальные. В частности, агентная система использует повторные итерации, результаты unit-тестов и review кода, а значит, получает больше возможностей для генерации и обратной связи, чем baseline. Поэтому наблюдаемую разницу нельзя свести к изменению одного изолированного фактора.
Этот эксперимент показывает работоспособность самого механизма обратной связи: тесты могут обнаружить ошибку, после чего агент получает возможность скорректировать решение. Однако работоспособность механизма не определяет величину его среднего эффекта на более широкой совокупности задач. Для такой оценки потребовалось бы сравнение системы и baseline на сопоставимых выборках и в сопоставимых условиях.
Таким образом, материал DeepSense демонстрирует работоспособную self-correcting-систему и высокий результат на выбранных задачах. Однако приведенное сравнение не позволяет надежно определить, какая часть разницы между 53,8% и 81,8% обусловлена именно изменением среды. Поэтому его нельзя интерпретировать как измеренный прирост на 28 процентных пунктов при неизменных остальных условиях.
13.3. Стоимость выполнения и результативность
Опубликованная средняя стоимость выполнения задачи различается в 15,25 раза:
0,61 / 0,04 = 15,25.
Однако это арифметическое соотношение двух значений из источника, а не результат экономического сравнения в рамках единого эксперимента. Даже при использовании одинакового набора задач более высокая стоимость выполнения сама по себе не означала бы экономическую неэффективность: дополнительные вычисления могут сокращать объем последующего человеческого труда или снижать последствия ошибок. Аналогично более высокая доля успешно выполненных задач сама по себе не подтверждает экономическую эффективность системы.
Для такого сравнения необходимо учитывать не только стоимость вычислений, но и число попыток, объем последующего человеческого труда, время выполнения, вычислительные ограничения, последствия ошибочных или непринятых результатов и стоимость поддержания необходимой среды. Более подходящей единицей измерения могла бы быть стоимость принятого изменения заданного качества, а не стоимость одного обращения к модели или выполнения отдельной задачи.
Поскольку результаты DeepSense и baseline получены на разных выборках, даже нормализация стоимости по доле успешно выполненных задач не сделает их экономически сопоставимыми. Такой расчет объединит стоимость и результативность, но не устранит различия в самих условиях измерения. Поэтому опубликованные значения $0,61 и $0,04 позволяют установить различие в средней стоимости выполнения задачи в соответствующих оценках, но не определить экономическое преимущество одной системы над другой.
13.4. Сравнение вклада модели и среды
Сравнение вклада модели и среды требует как минимум нескольких моделей и конфигураций окружения, протестированных на одном наборе задач. Такой факторный дизайн позволяет отдельно оценить эффект смены модели, эффект изменения среды и взаимодействие между ними. Последнее особенно важно: например, более сильная модель может эффективнее использовать обратную связь от тестов и инструментов, поэтому эффекты модели и среды не обязательно складываются независимо друг от друга.
Результат также зависит от выбранного режима сравнения. При одинаковом денежном бюджете более дорогая система может выполнить меньше итераций; при одинаковом числе попыток расходы будут различаться; при одинаковом времени результат может зависеть от задержек инструментов и других компонентов среды. Выбор режима определяется тем, какой именно эффект необходимо измерить, поэтому единственного универсального способа сравнения здесь нет.
Не менее важен выбор самих альтернатив. Если сравнивать близкие по возможностям модели в существенно различающихся средах, наблюдаемая разница с большей вероятностью будет связана со средой. При сравнении значительно различающихся моделей с минимальными изменениями окружения соотношение может оказаться обратным. Поэтому утверждение Environment > Model требует определения того, какие изменения модели и среды сопоставляются и по какому показателю оценивается их вклад. Двух отдельных значений производительности для установления такого соотношения недостаточно.
13.5. Интерпретация результатов DeepSense
| Переход | Статус |
|---|---|
| Источник → опубликованные результаты и стоимость | Подтверждается первичным материалом |
| Результаты → наличие работоспособной итеративной системы | Подтверждается описанием и результатами реализации |
| Разница результатов → эффект среды величиной 28 п. п. | Не установлен из-за различий в выборках и условиях оценки |
| Частный результат → общий принцип Environment > Model | Не установлен: необходимое сравнение вклада моделей и среды не проводилось |
| Environment > Model → приоритет инвестиций в среду | Нормативный вывод, который дополнительно зависит от исходного состояния системы, доступных альтернатив и их стоимости |
Разбор DeepSense показывает, как масштаб допустимого вывода меняется на разных этапах интерпретации одного источника. Первичный материал подтверждает работоспособность итеративной системы и опубликованные для нее результаты, но не позволяет выделить эффект среды величиной 28 процентных пунктов или распространить этот результат на общий принцип Environment > Model. Тем более из него непосредственно не следует универсальный приоритет инвестиций в среду. Это не ставит под сомнение значимость среды для агентной разработки, но отделяет подтвержденные результаты от более широких причинных и нормативных выводов.
14. Внутренние данные Сбера и переносимость результатов
В § 1.1 полной версии прямо указано, что приведенные оценки основаны на внутренних наблюдениях Сбера и публичных вендорских бенчмарках. Эти основания необходимо различать. Внешнее исследование само по себе не подтверждает внутреннюю оценку Сбера, а отсутствие опубликованной методики внутренних измерений не означает, что соответствующие наблюдения недостоверны.
Для принятия внутренних решений организация может располагать значительно более полной информацией о задачах, командах, инфраструктуре и полученных результатах, чем доступно внешнему читателю. Локального сравнения может быть достаточно для решения, относящегося к сходным условиям, если организации известны качество данных и ограничения такого сравнения. Для внешнего использования возникает другой вопрос: насколько полученный результат сохраняется за пределами исходного контекста.
Без опубликованной методики нельзя независимо установить:
- состав выборки и способ ее формирования, включая учет неуспешных внедрений;
- исходный baseline и сопоставимость сложности задач;
- определения производительности и качества, а также полный состав учитываемых затрат;
- продолжительность наблюдения и устойчивость полученного эффекта;
- контрольные условия, сопутствующие изменения и возможность отделить их влияние;
- различия между пилотными командами и остальной организацией;
- применимость результатов к другим отраслям, архитектурам и кадровому составу.
Речь идет о различии между внутренним использованием результатов и возможностью их независимой проверки и переноса в другой контекст. Для внешней обобщаемости особенно важна информация о случаях, в которых ожидаемый эффект не был достигнут, необходимых предпосылках и условиях, при которых затраты на контроль и инфраструктуру становятся сопоставимы с получаемым эффектом или превышают его.
В полном руководстве также приводятся примеры с численностью команд, эквивалентным объемом работы и экономией. Если такой пример не сопровождается указанием конкретного объекта, периода и способа измерения, его можно рассматривать как иллюстрацию расчета или заявленный результат, который невозможно независимо проверить по опубликованным материалам. Оснований автоматически считать каждый такой пример результатом измерений в конкретном подразделении Сбера нет.
В опубликованных материалах не представлено общедоступного контролируемого исследования, сравнивающего внедрение AI-Disrupt PDLC в целом с альтернативной организационной моделью. Это не исключает наличия внутренних внедрений и измерений, но означает, что их результаты нельзя независимо использовать для оценки эффективности всей конструкции за пределами исследованного организационного контекста.
15. Производительность разработки и ее измерение
15.1. Уровни оценки результата
Coding speed ≠ development productivity ≠ delivery performance ≠ business outcome.
Эти понятия описывают разные уровни результата. Coding speed характеризует скорость выполнения отдельных операций с кодом. Development productivity отражает соотношение получаемого инженерного результата и затрачиваемых на него ресурсов. Delivery performance характеризует способность команды или организации поставлять изменения с определенной скоростью и стабильностью. Business outcome относится уже к изменениям в продукте или бизнесе: например, поведению пользователей, стоимости обслуживания или качеству выполняемых операций.
Улучшение показателя на одном уровне не гарантирует улучшения на следующем. Быстрее написанный код может потребовать больше времени на проверку и интеграцию; увеличение числа принятых изменений может не повлиять на поведение пользователей; существенный бизнес-эффект, напротив, иногда достигается удалением функции и сокращением кодовой базы. Поэтому переход от локальной инженерной метрики к более широкому результату требует отдельного подтверждения.
Такое разграничение согласуется с моделью SPACE 2021 года, в которой производительность разработчиков рассматривается как многомерное понятие, не сводимое к одной активности или одному показателю. Количественные показатели инженерных артефактов при этом могут использоваться, но их значение определяется тем, какой именно аспект производительности они измеряют.
15.2. Количество строк кода как показатель производительности
LOC (Lines of Code) обозначает количество строк кода. В AI-Disrupt этот показатель используется буквально как число строк кода в месяц. Авторы при этом прямо указывают, что количество строк служит грубой иллюстрацией масштаба изменения, а не целевой метрикой или показателем ценности создаваемого кода. Полная версия, с. 7–8.
Эта оговорка ограничивает интерпретацию показателя, но не делает значения 2 000, 3 000 или 25 000 строк непосредственно сопоставимыми по полезному инженерному результату. Для такого сравнения потребовалось бы учитывать как минимум качество, сложность, повторное использование и сопровождаемость создаваемого решения. Условный показатель LOC-equivalent мог бы учитывать эти различия, однако в рассматриваемом фрагменте AI-Disrupt такая единица не определяется.
| Вид работы | Вопрос измерения |
|---|---|
| Ручной код | Считаются добавленные, измененные или принятые строки? Как учитывается повторная работа? |
| AI-generated code | Считаются все сгенерированные варианты или только итоговая реализация? Как учитываются отклоненные варианты? |
| Удаление кода | Как показатель отражает результат, если сокращение кодовой базы повышает качество или снижает трудоемкость сопровождения? |
| Рефакторинг | Как отделить полезное изменение структуры от увеличения объема diff? |
| Configuration и infrastructure as code | Сопоставимы ли строки декларативной конфигурации со строками прикладной логики? |
| Specification и тесты | Как учитывать вклад изменений требований, спецификаций и тестовых оракулов, не увеличивающих объем production-кода? |
| Low-code | Какая единица измерения соответствует визуальному компоненту, правилу или другому low-code-артефакту? |
| Автоматизация, устраняющая код | Как учитывать результат, достигнутый отказом от собственной реализации или сокращением необходимого объема кода? |
Без такой операционализации количество строк характеризует объем созданного или измененного кода в конкретном контексте, но не становится сопоставимой мерой полной инженерной производительности.
Есть и арифметическая неоднородность самих приведенных значений. Если использовать 2 000 строк как baseline, то 3 000 соответствуют росту в 1,5 раза, 5 000–8 000 — в 2,5–4 раза, а 15 000–25 000 — в 7,5–12,5 раза. Поэтому соседнее обобщение о росте в 5–10 раз не является точным пересчетом всей приведенной последовательности. Его можно интерпретировать как округленный ориентир, однако общий baseline и способ получения этого диапазона в опубликованном описании не определены.
15.3. Количество PR на разработчика как показатель производительности
Количество PR (Pull Request, запрос на включение изменений) на разработчика легко измеряется и может характеризовать интенсивность потока изменений. Однако значение показателя зависит от размера PR, принятой практики их дробления, автоматических обновлений, учета действий ботов, а также от того, какие PR включаются в расчет: созданные, принятые или объединенные.
В руководстве приводятся недельные ориентиры количества PR на разработчика для разных уровней команд. Эти значения нельзя непосредственно интерпретировать как показатель качества или производительности отдельного инженера. Один и тот же объем изменений может быть оформлен одним крупным PR или несколькими небольшими, а рост их количества при одновременном увеличении объема переделок имеет иной смысл, чем рост числа независимо завершенных изменений.
При стабильных правилах учета количество PR может использоваться как показатель потока изменений и его динамики. Для оценки производительности этого недостаточно: необходимо учитывать как минимум размер и характер изменений, их качество после выпуска, объем последующей переработки и затраты на review, тестирование и другие проверки.
15.4. Объем создаваемых артефактов как показатель производительности
В полной версии AI Output Volume определяется как отношение количества созданных за период артефактов к исходному уровню, а для Output Volume Lift устанавливаются ориентиры более 2 для зрелых команд и более 3 для отдельных высокоэффективных команд. Основное ограничение такого показателя, на мой взгляд, связано с объединением в одной величине неоднородных артефактов.
Функция, исправление, обновление зависимости и документ представляют разные виды результата и не образуют непосредственно сопоставимые единицы. Простое суммирование делает показатель чувствительным к тому, как работа разделяется на отдельные артефакты и как они классифицируются. Использование весов могло бы учитывать различия между типами работы, но потребовало бы отдельного обоснования этих весов и стабильности правил их применения во времени.
Более узкая операционализация могла бы состоять в раздельном учете однородных типов принятых артефактов с последующим использованием агрегированного показателя только внутри стабильного и сопоставимого потока работы. Такой подход позволил бы использовать Output Volume Lift для наблюдения за динамикой в определенном контексте, но сам по себе не подтверждал бы универсальность пороговых значений более 2 и более 3.
15.5. Временные показатели и границы измерения
Cycle Time, Lead Time и Spec-to-Deploy могут характеризовать разные интервалы процесса в зависимости от того, в какой точке начинается измерение. Сокращение времени от утвержденной спецификации до deploy может сочетаться с увеличением продолжительности Discovery. Если часть работы переносится между стадиями, показатель с более поздней точкой отсчета может демонстрировать сокращение времени без сокращения полного цикла.
Для AI-Disrupt это особенно существенно, поскольку подход предполагает увеличение объема работы на этапах формирования Intent и спецификации. Такое перераспределение усилий может быть оправданным и положительно влиять на итоговый результат, однако для его оценки необходимо одновременно учитывать локальный цикл реализации и сквозное время до получения результата. Иначе изменение границы измерения можно принять за изменение производительности.
15.6. Показатели разработки и бизнес-результата
В полной версии AI-Disrupt используются не только показатели количества строк кода, PR и других инженерных артефактов. В систему метрик также входят Outcome Validation Rate, Cost-to-Outcome Ratio, Time-to-Business-Impact, Reallocation Rate и парные показатели качества и скорости. Поэтому измерительная модель AI-Disrupt не ограничивается объемом выпуска кода. Полная версия, часть 6, с. 121–130.
AI-Disrupt использует показатели нескольких уровней: объема инженерных артефактов (output), потока поставки (flow/delivery), качества и стабильности, экономики и бизнес-результата. Наличие LOC, PR или Output Volume Lift само по себе поэтому не противоречит outcome-oriented подходу. Однако показатели разных уровней не являются взаимозаменяемыми: увеличение output не означает автоматически улучшения delivery performance, а улучшение delivery performance само по себе не устанавливает наличие положительного business outcome. Переход от показателя одного уровня к выводу о другом требует отдельного обоснования.
То же ограничение относится к использованию роста количества артефактов как показателя зрелости. Объем выпуска может характеризовать промежуточную производственную мощность при одновременной оценке качества и outcomes, но достижение установленного порога Output Volume само по себе не подтверждает необходимость или эффект выполненных работ.
Использование парных метрик позволяет одновременно учитывать разные характеристики результата, но не устанавливает причинную связь между ними. Например, одновременное сокращение Lead Time и рост Output Volume могут быть связаны не только с увеличением полезного выпуска, но и с изменением размера и состава учитываемых работ. Аналогично низкая частота отказов не исключает наличия невыявленных дефектов или поставки функции, не создающей ожидаемого бизнес-эффекта.
Отдельная измерительная проблема возникает для Reallocation Rate, поскольку этот показатель зависит от оценки сэкономленного времени. Время, которое потребовалось бы для выполнения той же работы без ИИ, непосредственно измерить нельзя, поэтому его приходится оценивать с помощью модели или сопоставимого сравнения. При этом отсутствие роста объема выпуска не означает отсутствия эффекта от применения ИИ: экономия времени может использоваться для снижения перегрузки, обучения или уменьшения эксплуатационного риска. Такие эффекты требуют отдельных показателей и не должны автоматически интерпретироваться как отсутствие создаваемой ценности.
15.7. Расхождение в перечне компетенций DORA
В части 6 AI-Disrupt в качестве семи исходных компетенций DORA перечислены использование инструментов, review, тестирование, документация, безопасность, работа с инцидентами и обучение. Затем к этому перечню предлагается добавить AI Output Volume.
В официальном инструменте DORA AI Capabilities Model приведен другой набор из семи способностей: ясная и доведенная до сотрудников позиция по использованию ИИ, здоровая экосистема данных, доступность внутренних данных для ИИ, развитые практики контроля версий, небольшие партии изменений, ориентация на пользователя и качественная внутренняя платформа.
Таким образом, перечень, обозначенный в AI-Disrupt как исходные компетенции DORA, не соответствует составу DORA AI Capabilities Model. Предложенная Сбером группировка может рассматриваться как собственная система категорий, однако ее происхождение в таком случае необходимо отделять от модели DORA. Обозначение последующей таблицы как «агентной адаптации» этого различия не меняет, поскольку в предшествующем ей тексте семь перечисленных пунктов прямо представлены как исходные компетенции DORA.
Это расхождение само по себе не определяет полезность предложенных метрик. Оно относится к их атрибуции и означает, что приведенный перечень не может быть обоснован составом DORA AI Capabilities Model без дополнительного источника или объяснения преобразования исходной модели.
16. Масштаб и сроки заявленных эффектов
16.1. Оценка сокращения трудоемкости
В полной версии приводится пример, согласно которому работа, ранее требовавшая 20 человеко-лет, выполняется командой из 4–6 разработчиков за три месяца. При буквальном пересчете:
20 × 12 = 240 человеко-месяцев;
4 × 3 = 12 человеко-месяцев;
6 × 3 = 18 человеко-месяцев.
Отношение исходной трудоемкости к новой составляет:
240 / 18 ≈ 13,3 и 240 / 12 = 20.
Таким образом, приведенные значения соответствуют примерно 13,3–20-кратному сокращению трудоемкости, или ее снижению на 92,5–95%. Это не совпадает с соседним обобщением о сокращении трудоемкости в 5–10 раз. Такое различие само по себе не означает противоречия: значения могут относиться к разным типам задач или условиям выполнения работы. Однако интерпретировать их как результаты одного согласованного расчета можно только при наличии общего определения учитываемых работ и способа их сопоставления.
Человеко-годы характеризуют трудоемкость, а не календарную продолжительность проекта. Из величины 20 человеко-лет нельзя определить, сколько календарного времени занимала исходная работа и сколько человек одновременно участвовало в ее выполнении. Поэтому приведенное сопоставление позволяет рассчитать изменение трудоемкости, но не коэффициент сокращения календарного срока.
Для оценки масштаба эффекта также необходимо знать, представляли ли 20 человеко-лет фактическую трудоемкость сопоставимого проекта или предварительную оценку, были ли сопоставимы объем и качество результата и одинаково ли учитывалась эксплуатационная ответственность. Существенно и то, входят ли в расчет затраты на платформу, подготовку данных, сопровождение и человеческую валидацию. Рассмотренные выше публичные исследования GitHub Copilot и Accenture не подтверждают сокращение трудоемкости именно в 13,3–20 раз при сопоставимых условиях.
Арифметическое соотношение приведенных в AI-Disrupt значений воспроизводится, однако опубликованные материалы не содержат методики, позволяющей независимо проверить сопоставимость исходных 20 человеко-лет и работы команды из 4–6 разработчиков в течение трех месяцев. Поэтому установленным по опубликованным данным результатом здесь является само заявленное соотношение трудоемкости, а не его переносимость на другие проекты или организации.
16.2. Что включает в себя период 12–18 месяцев
В полной версии диапазон 12–18 месяцев относится к нескольким разным объектам: начальному построению IDP, переходу от L3 к L4 и отдельным аспектам подготовки специалистов и наставничества. Общая программа трансформации при этом разделена на горизонты 0–6, 6–18 и 18–36 месяцев, а в обзорном изложении рассматривается и более длительная организационная перспектива.
Поэтому период 12–18 месяцев не является единым сроком завершения всей трансформации AI-Disrupt. Продолжительность отдельной фазы, время развития компетенций, срок окупаемости и стратегическое «окно» описывают разные временные характеристики. В краткой версии стратегический выбор также связывается с горизонтом 2028–2030 годов, однако этот горизонт не является календарным планом конкретного внедрения.
Даже применительно к конкретной фазе указанный срок остается плановой оценкой. Возможность его переноса на другую организацию зависит от исходного состояния процессов и инфраструктуры, доступных ресурсов, размера организации, числа необходимых интеграций, требований к данным и критериев завершения соответствующей фазы. Поэтому сам диапазон 12–18 месяцев без описания этих условий не позволяет определить ожидаемую продолжительность аналогичного перехода в конкретной организации.
16.3. Прогнозы AI-Disrupt на 2027–2030 годы
Авторы прямо обозначают стратегические прогнозы как сценарии, а не гарантии. Поэтому приведенные значения описывают возможные будущие изменения при определенных предпосылках, а не результаты, которые должны быть достигнуты в указанные сроки. Подтвержденный прогноз Gartner об использовании ИИ-ассистентов к 2028 году относится к ожидаемому распространению технологии, но не определяет долю автономной работы и не подтверждает конкретные эффекты AI-Disrupt.
Для прогноза о сокращении количества дефектов на 60% существенны определение дефекта, база сравнения, период наблюдения и сопоставимость рассматриваемых групп. Аналогично прогноз об отставании без SDD на 25% зависит от того, какой показатель понимается под «скоростью» и относительно какой группы организаций оценивается отставание. Формулировка о сокращении доли ручного кода с 50% до 25% требует определить, относится ли эта доля к объему текста кода, количеству изменений, затратам человеческого времени или реализованной функциональности. Без таких определений одинаковые числовые значения могут описывать существенно разные изменения.
Отдельно необходимо различать долю рабочего времени, затрачиваемого на написание нового кода, и долю кода, созданного человеком вручную. Первый показатель характеризует распределение рабочего времени, второй — происхождение создаваемого артефакта. Поэтому изменение одного показателя не позволяет непосредственно определить изменение другого.
В стратегической аргументации прогноз распространения технологии используется также как основание для решений об инвестициях в соответствующую архитектуру. Однако выбор конкретного варианта требует учитывать доступные альтернативы, стоимость задержки, неопределенность и обратимость решения. Ожидаемое распространение ИИ-ассистентов само по себе не определяет выбор между созданием собственной платформы, использованием внешних решений, ограниченным внедрением или сочетанием нескольких подходов.
16.4. Влияние среды и модели на результат
Значения 22 п. п. для различий между средами и 1–3 п. п. для различий между моделями нельзя вывести из рассмотренного выше исследования DeepSense: в нем приведены другие числовые значения и использован другой дизайн сравнения. В AI-Disrupt эти показатели сопровождаются общей ссылкой на технологических консультантов, однако точный первичный источник, позволяющий воспроизвести соответствующее сравнение, не идентифицирован.
Для содержательного сопоставления этих значений необходимо знать название и версию моделей, определение сравниваемых сред, критерии выбора «лучших» и «худших» моделей, набор задач, число повторов, вычислительный бюджет и период проведения оценки. Даже если оба значения получены эмпирически, их прямое сравнение требует сопоставимого дизайна. Различия между средами в одной выборке и различия между моделями в другой не позволяют определить относительный вклад этих факторов.
Кроме того, изменение успешности в процентных пунктах не является показателем экономической отдачи. Для инвестиционного сравнения необходимо учитывать стоимость улучшения среды и смены модели, продолжительность получаемого эффекта и возможное взаимодействие этих изменений. Поэтому принцип «сначала среда, затем модель» в опубликованных материалах AI-Disrupt представляет собой авторский приоритет, поддержанный инженерной аргументацией, но универсальность такого порядка инвестиций не установлена.
17. Результаты исследования
В ходе проведенного мной анализа я последовательно рассмотрел происхождение элементов AI-Disrupt, характер их адаптации и композиции, а также доказательный статус утверждений о свойствах и ожидаемых эффектах системы. Эти аспекты необходимо рассматривать совместно: происхождение отдельных элементов само по себе не определяет характер авторского вклада, а характер этого вклада не устанавливает доказательный статус связанных с ним утверждений. Ни один из этих аспектов отдельно не определяет профессиональный статус или применимость всей конструкции. Ниже полученные результаты объединены мной в общую характеристику AI-Disrupt PDLC.
17.1. Происхождение элементов AI-Disrupt и авторский вклад
| Группа | Установленный результат |
|---|---|
| Предшествующие практики | Discovery, PR/FAQ, гипотезы результата, AI-DLC, Mob Elaboration, SDD, платформы самообслуживания, Golden Paths, машиноисполняемые политики, непрерывные проверки, provenance и агентный надзор документированы до появления AI-Disrupt |
| Адаптации | Существующие практики адаптированы к контексту агентного исполнения, длительных сессий, динамических полномочий и корпоративной прослеживаемости |
| Композиционные вклады | Две петли, платформенный слой, Governance Mesh, Validation Spine, Evidence Bundle, Outcome Check и организационные модели объединены в единую целевую систему с определенными ролями и связями |
| Потенциально собственные конструкты | Для точной композиции двух петель, архитектурной роли Validation Spine, восьмикомпонентного контракта Evidence Bundle и отдельных авторских шкал в проведенном поиске не установлены достаточно близкие предшественники. Этот результат относится к проведенному поиску и не устанавливает абсолютную оригинальность конструкций |
| Авторские гипотезы | Перенос главного ограничения к Intent, приоритет среды над моделью, нормативы инвестиций и зрелости, структура команд и траектории перехода требуют отдельной проверки в конкретных условиях применения |
| Эмпирические утверждения | Часть количественных утверждений имеет первичные основания более узкого масштаба, часть представляет собой прогнозы, а для ряда внутренних оценок и точных внешних значений публичная методика не установлена |
Компонентная и композиционная новизна различаются. Наличие известных составляющих не исключает авторского вклада в архитектуру их связей. Одновременно новизна общей схемы не означает авторства AI-Disrupt в отношении PR/FAQ, SDD, Golden Paths или Guardian Agents как отдельных концепций.
17.2. Классификация AI-Disrupt как профессионального продукта
AI-Disrupt сочетает в себе свойства нескольких классов профессиональных продуктов. При этом содержательные свойства системы, форма ее публикации и возможность модульного применения отдельных практик характеризуют ее с разных сторон и не требуют выбора одного исключительного класса.
| Класс | Наблюдаемые свойства AI-Disrupt | Ограничения |
|---|---|---|
| Conceptual model | Intent/Implementation, роль среды, представление о переносе ограничений | Объяснительная модель сама по себе не устанавливает причинные закономерности |
| Framework | Понятийный аппарат, практики, роли, уровни и механизмы | Конкретная реализация зависит от условий и решений организации |
| Reference architecture | IDP, runtime, контекст, валидация, governance, аудит и связи между компонентами | Не все интерфейсы и правила разрешения конфликтов определены в виде исполнимых контрактов |
| Operating model | Распределение работы между людьми, агентами, продуктовыми и платформенными командами | Не все полномочия по принятию решений полностью операционализированы, особенно при возврате нового знания из Implementation в Intent; результативность организационной модели в целом не установлена публичным сравнительным исследованием |
| Maturity model | L0–L5 и критерии переходов характеризуют освоение целевой системы способностей и практик AI-Disrupt | Зрелость освоения системы не тождественна независимо подтвержденной эффективности; связь уровней с внешними результатами требует отдельной валидации |
| Методология в профессиональном смысле | Система взаимосвязанных принципов и процедур Discovery, SDD, проверки и управления | Методологический статус сам по себе не определяет новизну составляющих или их композиции и не подтверждает эффективность системы в целом |
По форме публикации AI-Disrupt является практическим руководством: оно содержит рекомендации, шаблоны, дорожную карту и нормативы, часть которых представляет собой авторские плановые оценки.
В прикладном отношении AI-Disrupt может рассматриваться также как набор взаимосвязанных практик, часть которых допускает модульное применение. Использование отдельных практик не тождественно внедрению всей конструкции и не исчерпывает ее содержательных свойств.
Таким образом, AI-Disrupt сочетает свойства conceptual model, framework, reference architecture, operating model, maturity model и методологии в профессиональном смысле. Выбор одного из этих классов в качестве единственной характеристики не отражал бы всей конструкции. Практическое руководство описывает форму ее представления, а возможность модульного применения отдельных практик — один из способов использования.
17.3. Доказательная база и границы подтвержденных выводов
Проведенный анализ позволяет выделить три уровня доказательной поддержки. Первый относится к происхождению практик: для значительной части элементов AI-Disrupt установлены близкие предшествующие практики и соответствующие первичные источники. Второй охватывает эмпирические результаты отдельных инструментов и режимов работы: такие исследования существуют, но используют собственные выборки, условия и показатели и поэтому не подтверждают автоматически эффективность AI-Disrupt в целом. Третий относится к эффективности AI-Disrupt в целом: среди рассмотренных источников не установлено опубликованного эмпирического исследования, оценивающего применение всей конструкции.
Проверка отдельных количественных утверждений выявила дополнительные ограничения их интерпретации. Исследование DeepSense не сопоставляет два режима на одной выборке из 225 задач. Для значений 22 п. п. различия между средами и 1–3 п. п. различия между моделями не идентифицирован первичный источник, позволяющий воспроизвести соответствующее сравнение. Пересчет примера с 20 человеко-лет показывает 13,3–20-кратное сокращение трудоемкости, но не устанавливает 5–10-кратного ускорения всего жизненного цикла. Для части приведенных прогнозов первичные источники установлены, тогда как основания некоторых других точных значений остаются неустановленными. Перечень семи компетенций, представленный в AI-Disrupt как исходный перечень DORA, отличается от официальной модели DORA AI Capabilities Model.
Эти результаты определяют границы доказательного статуса отдельных утверждений AI-Disrupt, но не позволяют переносить их на систему в целом. Недостаточная публичная подтвержденность конкретного количественного утверждения не означает отсутствия внутренних наблюдений, на которых оно может основываться, а отсутствие опубликованной эмпирической проверки AI-Disrupt в целом само по себе не устанавливает его неэффективность. По опубликованным материалам можно оценивать доступную доказательную базу и границы подтвержденных выводов, но не результаты, методика получения которых публично не представлена.
17.4. Неоднозначность архитектуры, шкал и показателей
Validation Spine может непротиворечиво рассматриваться как функционально выделенная часть Governance Mesh, однако ее архитектурная роль, владельцы и границы ответственности требуют более точного определения. Обратная связь между Implementation и Intent в AI-Disrupt предусмотрена, но полнота этого механизма зависит также от того, при каких условиях новое знание возвращается в Intent и кто имеет полномочия изменять Intent, Outcome Hypothesis и критерии приемки.
Шкала R0–R5 объединяет разрешенную автономию, полномочия, риск и условия исполнения. Предложенный механизм понижения уровня требует дополнительных правил применения, поскольку используемая в нем арифметика сама по себе не определяет соотношение между этими факторами. Шкала L0–L5 характеризует степень освоения организацией целевой системы способностей и практик AI-Disrupt. Связь достигнутого уровня с результативностью требует отдельной эмпирической валидации и не может быть установлена только на основании положения организации на этой шкале.
В AI-Disrupt используются показатели объема инженерных результатов, потока поставки, качества и стабильности, экономики и бизнес-результата. Совместное использование показателей этих уровней не является противоречием, однако переход от показателя одного уровня к выводу о другом требует отдельного обоснования. При оценке Tiny Teams необходимо учитывать не только состав самой команды, но и общие платформенные и контрольные функции, обеспечивающие ее работу. Иначе сравнение команд разного размера может фактически охватывать разные объемы организационных ресурсов.
17.5. Условия и границы применимости AI-Disrupt
Архитектурная часть AI-Disrupt в наибольшей степени ориентирована на организации с повторяемыми потоками изменений и возможностью развивать общую платформенную инфраструктуру. Ее применение предполагает наличие ресурсов для управления контекстом, проверок и governance. При этом AI-Disrupt допускает использование разных режимов работы с ИИ в зависимости от характера задач.
Отдельные практики AI-Disrupt могут применяться и в других условиях без внедрения всей конструкции. Перенос целой модели в организацию с иной структурой затрат, небольшим потоком задач или высокой долей исследовательской работы с неопределенным результатом требует отдельной оценки исходных условий. То же относится к интерпретации L0–L5: организация может достигать высоких результатов, не соответствуя отдельным признакам верхних уровней шкалы. Это не противоречит самим наблюдаемым результатам, но показывает, что соответствие архитектурной модели и эффективность организации являются разными характеристиками.
При оценке применимости AI-Disrupt в конкретной организации необходимо раздельно ответить на три вопроса: нужен ли ей конкретный механизм, оправдано ли его использование именно в предложенной системе взаимосвязей и подтвержден ли ожидаемый эффект в сопоставимых условиях. Опубликованные материалы AI-Disrupt обосновывают эти аспекты в разной степени.
18. Ограничения исследования
Мое исследование рассматривает опубликованные материалы AI-Disrupt, а не фактическую внутреннюю практику Сбера. Доступные документы не позволяют восстановить все реализации, пилоты и внутренние измерения. Внутренние данные могут существовать без опубликованной методики, поэтому недостаточная внешняя проверяемость отдельных утверждений не означает отсутствия данных, на которых они основаны.
Проведенный мной поиск предшественников не гарантирует их абсолютной полноты. Не все корпоративные документы находятся в открытом доступе, не все материалы индексируются поисковыми системами, а одинаковые или близкие практики могут описываться разными терминами. Поэтому отсутствие обнаруженного близкого предшественника не доказывает абсолютной оригинальности конструкции, а наличие более раннего аналога само по себе не устанавливает прямого заимствования.
Мое исследование не включает в себя контролируемый эксперимент по внедрению AI-Disrupt, повторение внешних бенчмарков, аудит исходных данных Сбера или независимую проверку программных реализаций. Выполненные арифметические пересчеты и анализ дизайна опубликованных исследований позволяют проверить отдельные утверждения и способы их интерпретации, но не заменяют таких процедур.
Внешние исследования относятся к разным инструментам, периодам, организациям, задачам и показателям результата. Поэтому полученные в них эффекты не рассматриваются в этом исследовании как значения одной общей величины и не используются для расчета единой оценки эффективности AI-Disrupt. Сами исследования также имеют собственные ограничения, включая данные, основанные на оценках самих участников, небольшие выборки и особенности отбора задач.
19. Заключение
Я считаю, что проведенное мной исследование позволяет ответить на поставленный вопрос. AI-Disrupt PDLC представляет собой многоклассовую систему организации ИИ-нативной разработки, сочетающую свойства conceptual model, framework, reference architecture, operating model, maturity model и методологии в профессиональном смысле. Большинство рассмотренных составляющих имеют документированные предшественники, а авторский вклад состоит прежде всего в их адаптации к агентному исполнению и объединении в общую архитектуру. Для отдельных конструкций достаточно близкие предшественники в проведенном мной поиске не установлены.
Таким образом, новизна AI-Disrupt имеет прежде всего адаптационный и композиционный характер. Доказательный статус связанных с системой утверждений неоднороден: часть имеет прослеживаемые внешние основания, часть представляет собой прогнозы или авторские гипотезы, а для некоторых количественных утверждений публичные основания недостаточны для независимой проверки. Поэтому происхождение составляющих, характер авторского вклада и доказательный статус утверждений дают три самостоятельные характеристики AI-Disrupt, которые необходимо рассматривать раздельно.
Глоссарий
Определения передают значения терминов в этом исследовании. Пометка «в AI-Disrupt» указывает на использование термина в исследуемой конструкции, а не на его историческое происхождение. Рабочие определения исследования обозначены отдельно.
| Термин | Значение в исследовании |
|---|---|
| ИИ-нативная разработка (AI-native development) | Разработка, в которой ИИ встроен в жизненный цикл, а не используется только как отдельный помощник. |
| Agentic development | Агентная разработка: выполнение многошаговых задач агентами в заданной среде и пределах предоставленных полномочий. |
| Intent Loop | В AI-Disrupt — петля определения задачи, ценности, ограничений и критериев результата людьми при поддержке ИИ. |
| Implementation Loop | В AI-Disrupt — петля создания и изменения реализации агентами в пределах предоставленных полномочий, с проверками и обратной связью. |
| Discovery | Поиск и уточнение продуктовой задачи; в AI-Disrupt входит в Intent Loop и предшествует выбору способа автоматизации. |
| PR/FAQ | Формат описания будущей пользовательской ценности и ответов на ключевые вопросы; используется в Discovery. |
| Mob Elaboration | Совместное уточнение задачи продуктовой и инженерной группой с участием ИИ. |
| Outcome Hypothesis | В AI-Disrupt — проверяемая гипотеза результата с метрикой, baseline/target, ранним индикатором, окном проверки и fallback. |
| Outcome Check | В AI-Disrupt — последующая проверка гипотезы результата; отличается от завершения технической реализации. |
| Baseline | Исходный уровень показателя или базовый режим сравнения; конкретный смысл зависит от измерения или эксперимента. |
| Target | Целевое значение показателя, с которым сопоставляется наблюдаемый результат. |
| Leading indicator | Ранний индикатор предполагаемого результата; сам по себе не заменяет его последующей проверки. |
| Fallback | В шаблоне Outcome Hypothesis — альтернативное действие при неподтверждении гипотезы. |
| Agent-fit | Оценка пригодности агентного подхода для конкретной задачи. |
| SDD / Specification-Driven Development | Разработка через спецификацию; в AI-Disrupt спецификация задает нормативное намерение, с которым согласуется реализация. |
| Validation Spine | В AI-Disrupt — сквозной механизм валидации; в подробной архитектуре также описан как измерение Governance Mesh. |
| Governance Mesh | В AI-Disrupt — связанная система управления полномочиями и политиками, валидацией, аудитом и соответствием требованиям. |
| Evidence Bundle | В AI-Disrupt — комплект свидетельств завершения работы, включающий результаты проверок и данные, необходимые для прослеживаемости и последующей оценки. |
| Guardian Agents | Агенты надзора и вмешательства; в AI-Disrupt сами подчинены ограничениям, аудиту и оцениванию. |
| R0–R5 | В AI-Disrupt — классы разрешенной автономии с учетом полномочий, риска и условий исполнения; не являются чистой шкалой способностей агента. |
| L0–L5 | В AI-Disrupt — уровни освоения целевой системы способностей и практик; положение на шкале само по себе не определяет эффективность организации. |
| Risk-adaptive governance | Управление, при котором разрешения и надзор учитывают риск и условия конкретного действия. |
| IDP / Integrated Development Platform | Авторская расшифровка IDP в AI-Disrupt: единая операционная среда разработки, контекста, агентного исполнения, проверок и управления. |
| Internal Developer Platform | Внутренняя платформа разработки в platform engineering; иная расшифровка IDP, которую следует отличать от авторской Integrated Development Platform. |
| Platform engineering | Создание и развитие общих платформенных возможностей для разработчиков, включая самообслуживание и повторное использование. |
| Harness | Окружение агента: инструменты, контекст, инструкции, память, ограничения и телеметрия. |
| Agent runtime | Среда исполнения агента, обеспечивающая выполнение его работы. |
| Golden Paths | Поддерживаемые пути выполнения типовых инженерных задач; в AI-Disrupt адаптированы к агентному исполнению и прослеживаемости. |
| ADLC / Agent Development Lifecycle | Жизненный цикл агента как продукта: спецификация поведения, оценивание, развертывание, мониторинг и реакция на деградацию. |
| ModelOps / AgentOps | Управление жизненным циклом и эксплуатацией моделей и агентов в общей платформе. |
| FinOps | В контексте исследования — управление расходами на работу среды и агентное исполнение. |
| A2A | Протокол межагентного взаимодействия, включенный в критерии перехода к L5 в AI-Disrupt. |
| Policy as Code | Формализация правил в машиноисполняемой форме для проверки и управления действиями. |
| Compliance as Code | Связывание требований соответствия, автоматизированных проверок и свидетельств их выполнения. |
| Evals | Оценочные проверки поведения и результатов агента на заданных задачах и по определенным критериям. |
| Provenance | Сведения о происхождении артефактов и цепочке их создания, используемые для прослеживаемости. |
| PR / Pull request | Запрос на слияние изменений; инженерный артефакт и единица некоторых показателей выпуска. Не тождествен PR/FAQ. |
| Tiny Teams | В AI-Disrupt — малые продуктовые команды, опирающиеся на агентов и общие платформенные и контрольные функции. |
| Zero Friction | В AI-Disrupt — ориентир на сокращение организационных разрывов и ожидания при сохранении необходимых механизмов контроля. |
| Conceptual model | По рабочему определению исследования — система понятий и отношений для объяснения предметной области. |
| Framework | По рабочему определению исследования — структура понятий, ролей и практик, конкретная реализация которой зависит от условий и решений организации. |
| Reference architecture | По рабочему определению исследования — образец компонентов, обязанностей и взаимодействий, допускающий разные реализации. |
| Operating model | По рабочему определению исследования — распределение работы, ответственности, полномочий, ресурсов и механизмов управления. |
| Maturity model | По рабочему определению исследования — уровни и критерии состояния или развития определенной способности или системы способностей. |
| Методология | В профессиональном смысле исследования — согласованная система принципов и методов с объяснением их выбора, взаимосвязи и границ применения. |
| Output | Объем произведенных инженерных артефактов; промежуточный уровень измерения, не тождественный ценности результата. |
| Outcome | Изменение состояния продукта или деятельности, ради которого выполняется работа; отличается от самого выпуска артефактов. |
| Delivery performance | Способность поставлять изменения с определенными скоростью и стабильностью. |
| Business outcome | Изменение состояния продукта или бизнеса, например поведения пользователей или стоимости обслуживания. |
| LOC | Lines of Code, количество строк кода. В исследовании рассматривается как показатель объема инженерных артефактов, сопоставимость которого зависит от правил учета. |
| Output Volume Lift | Рост объема инженерных артефактов относительно baseline; интерпретация зависит от состава артефактов и правил учета. |